Mellum2.1正式发布:面向编程智能体的快速开源模型
Mellum2.1 在真实环境中通过强化学习训练,专为在自有硬件上运行的编码智能体和快速子智能体打造。
今天,我们发布 Mellum2.1,这是我们在 6 月开源 的 12B 混合专家模型的下一个版本。架构自第 2 版以来没有变化:它仍然是一个紧凑、快速的模型,拥有 2.5B 激活参数,并以 Apache 2.0 许可证发布。变化的是预训练之后发生的一切。
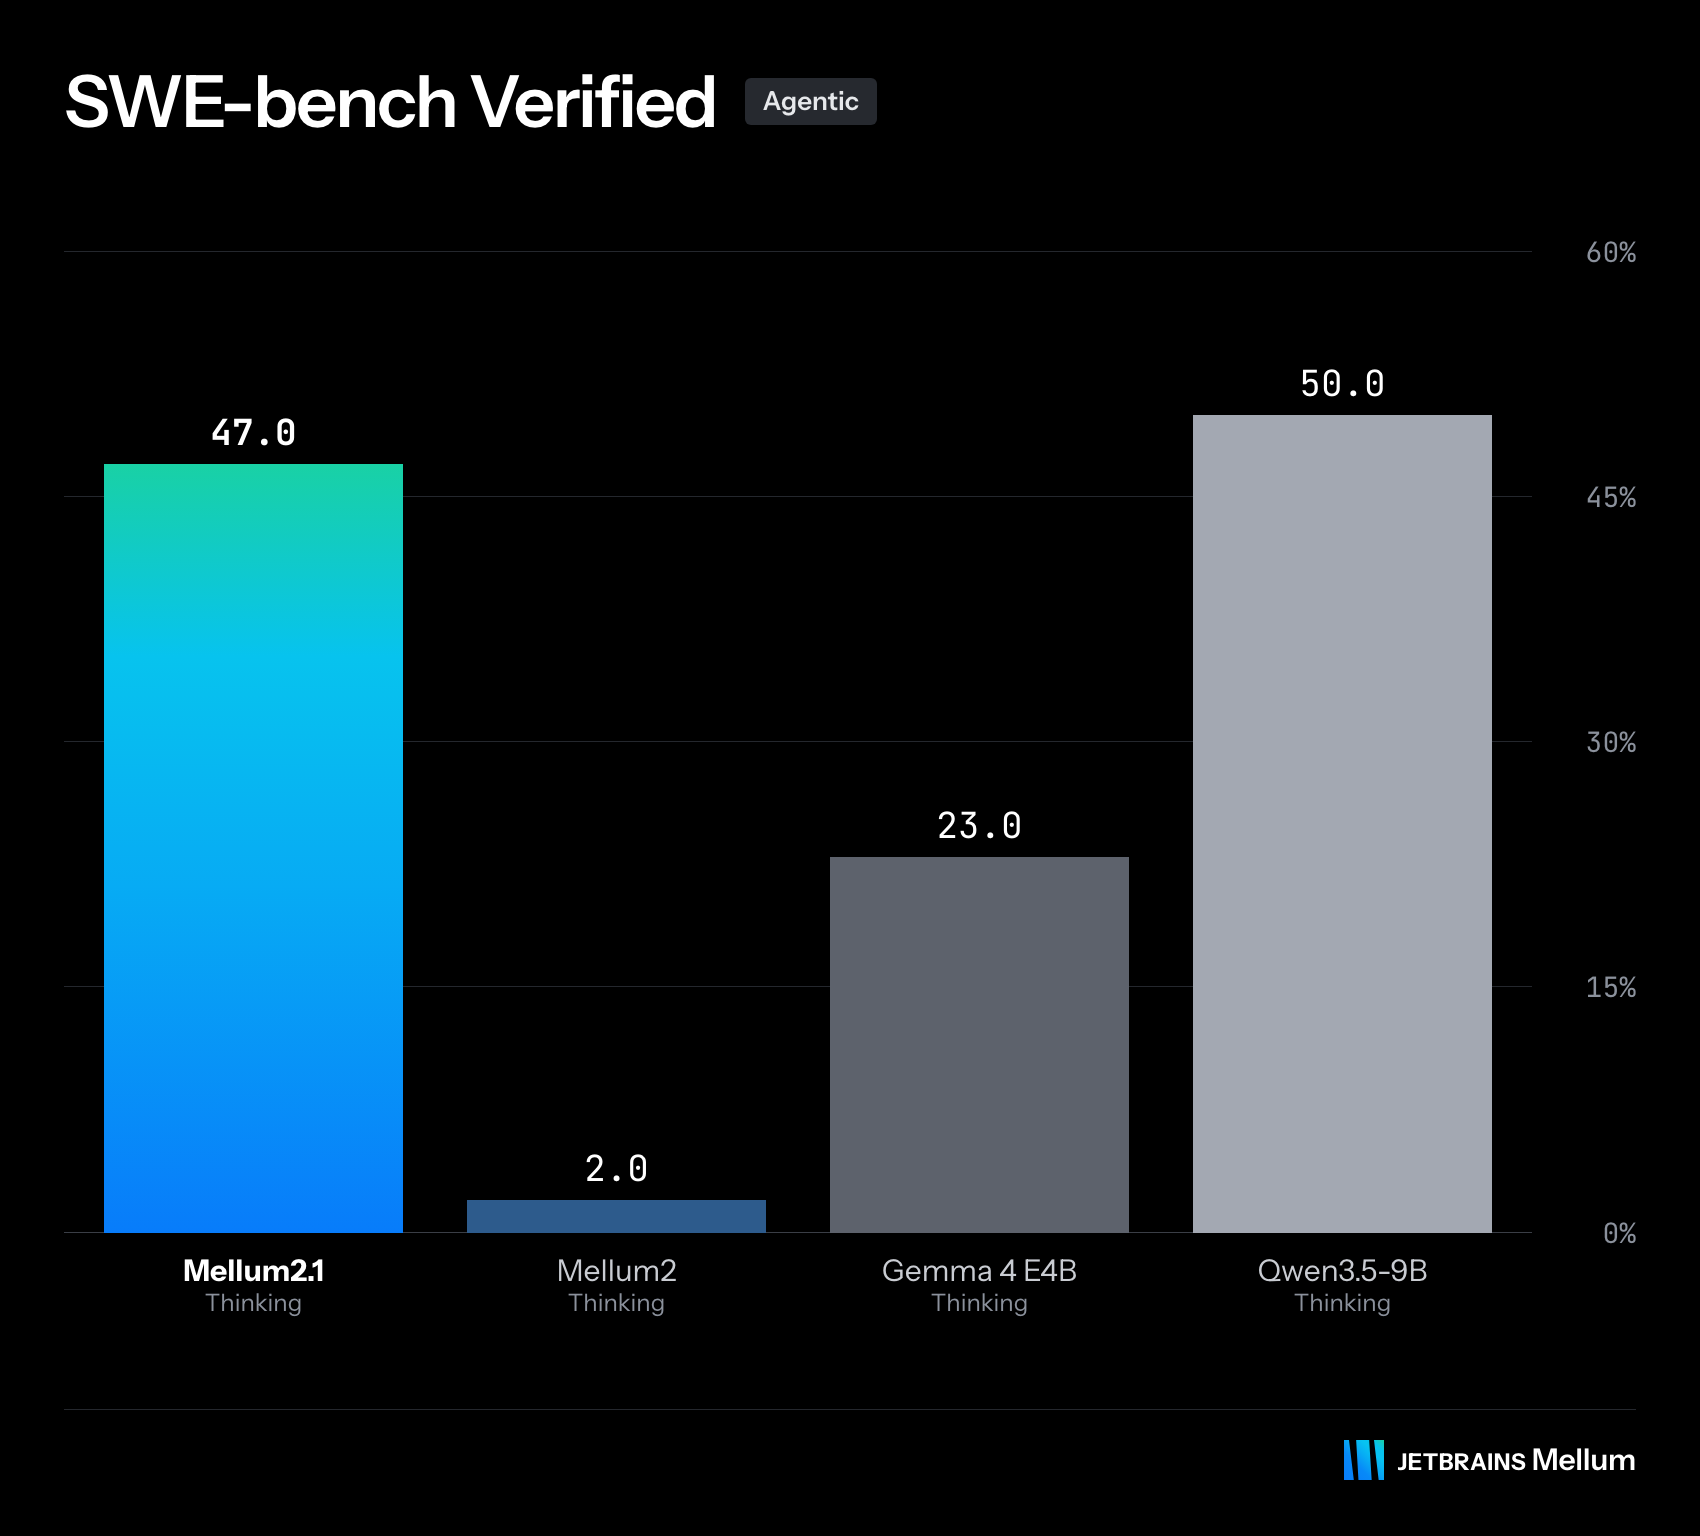
Mellum2 很快,但它无法以我们期望的水平在代码库中工作。经过一个夏天在真实环境中的强化学习,并在数千个环境中完成了数百万次沙盒运行后,Mellum2.1 做到了:它能探索代码库、编辑文件,并检查自己的改动。
我们在 Mellum2.1 中做出的改动
这个版本几乎所有工作都投入到了后训练中,主要是强化学习(RL)。
- 新规模的强化学习: 强化学习从一个短暂的最终阶段变成了训练的主要部分。我们围绕如何训练方法和数据开展了大量实验,并保留了真正有效的做法。
- 更多数据,更严格过滤: 我们在数学、竞赛编程、科学、工具使用和软件工程领域新增了强化学习任务,将开源 RL 数据集与我们自行构建的任务相结合。开源数据常常存在测试失效、答案无法验证,或者任务对模型来说过于简单或不可能完成等问题,因此每个来源在进入训练前都经过了过滤。
- 面向智能体技能的真实环境: 我们构建了在内部运行数千个 RL 环境的基础设施,并在训练过程中启动了数百万个沙盒。
Mellum2.1 的表现
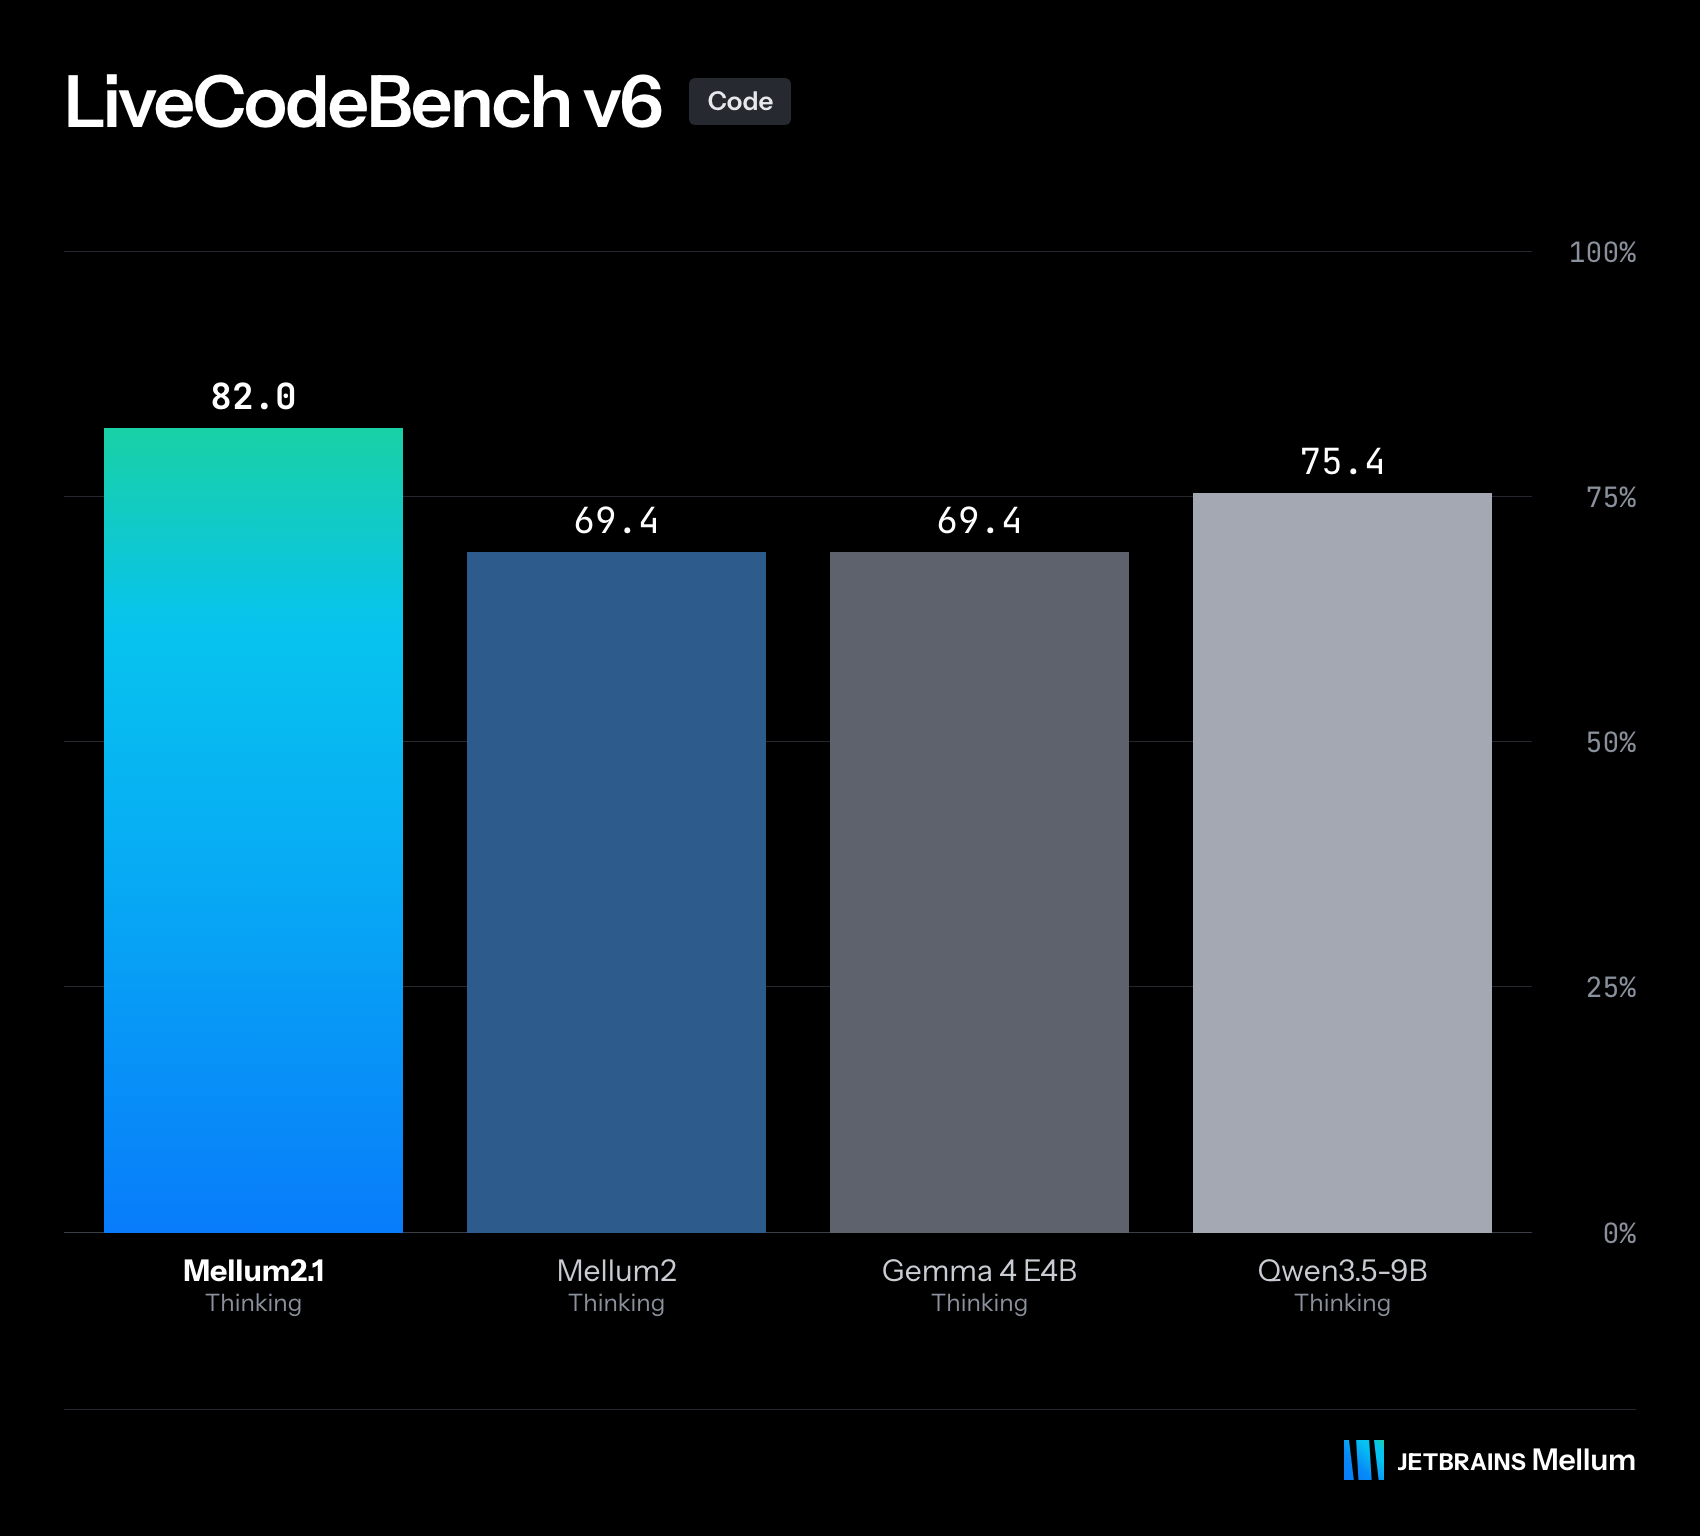
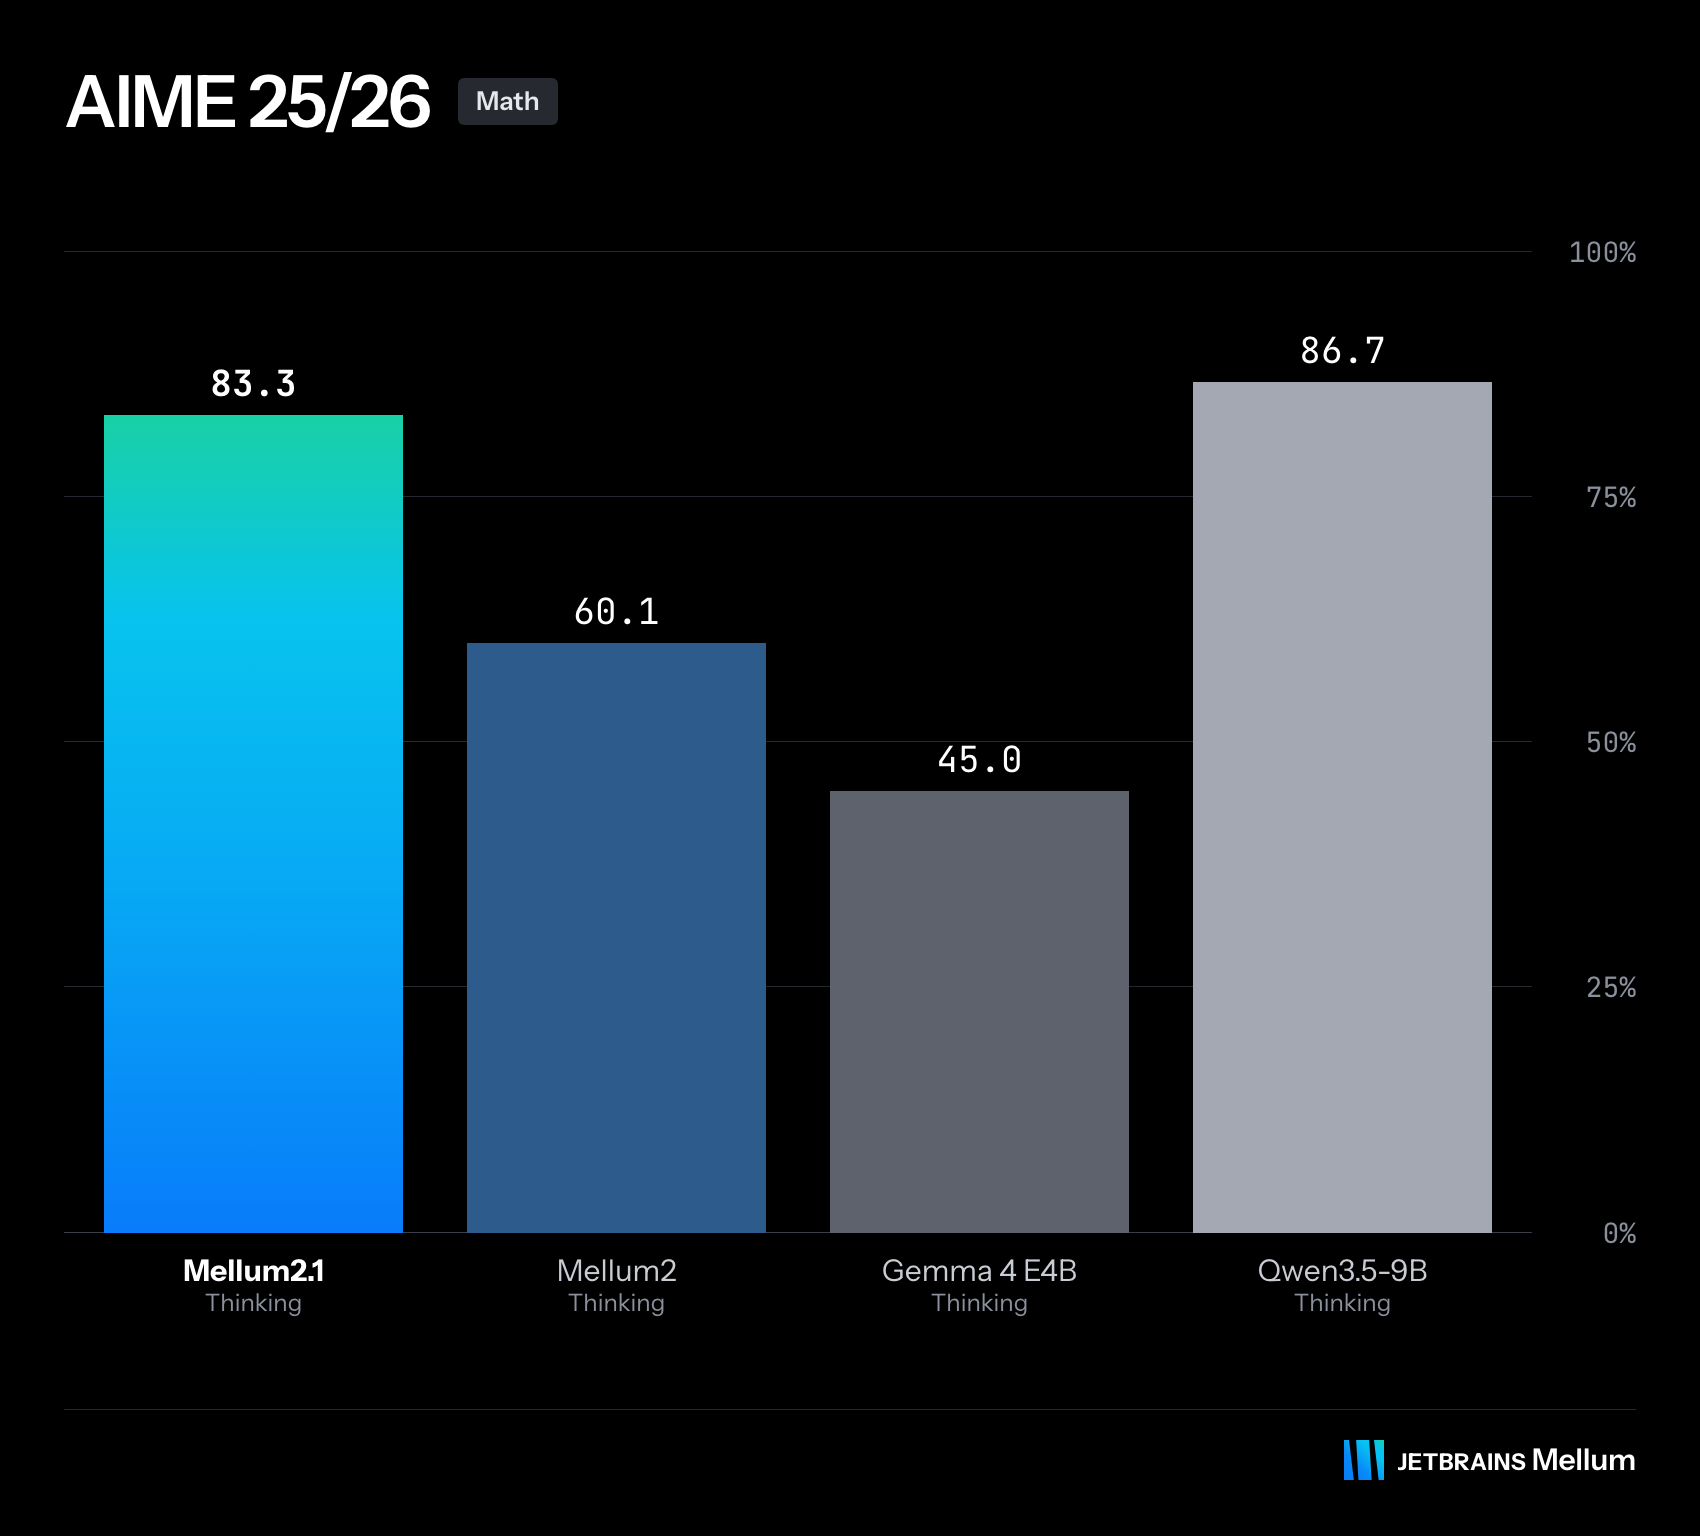
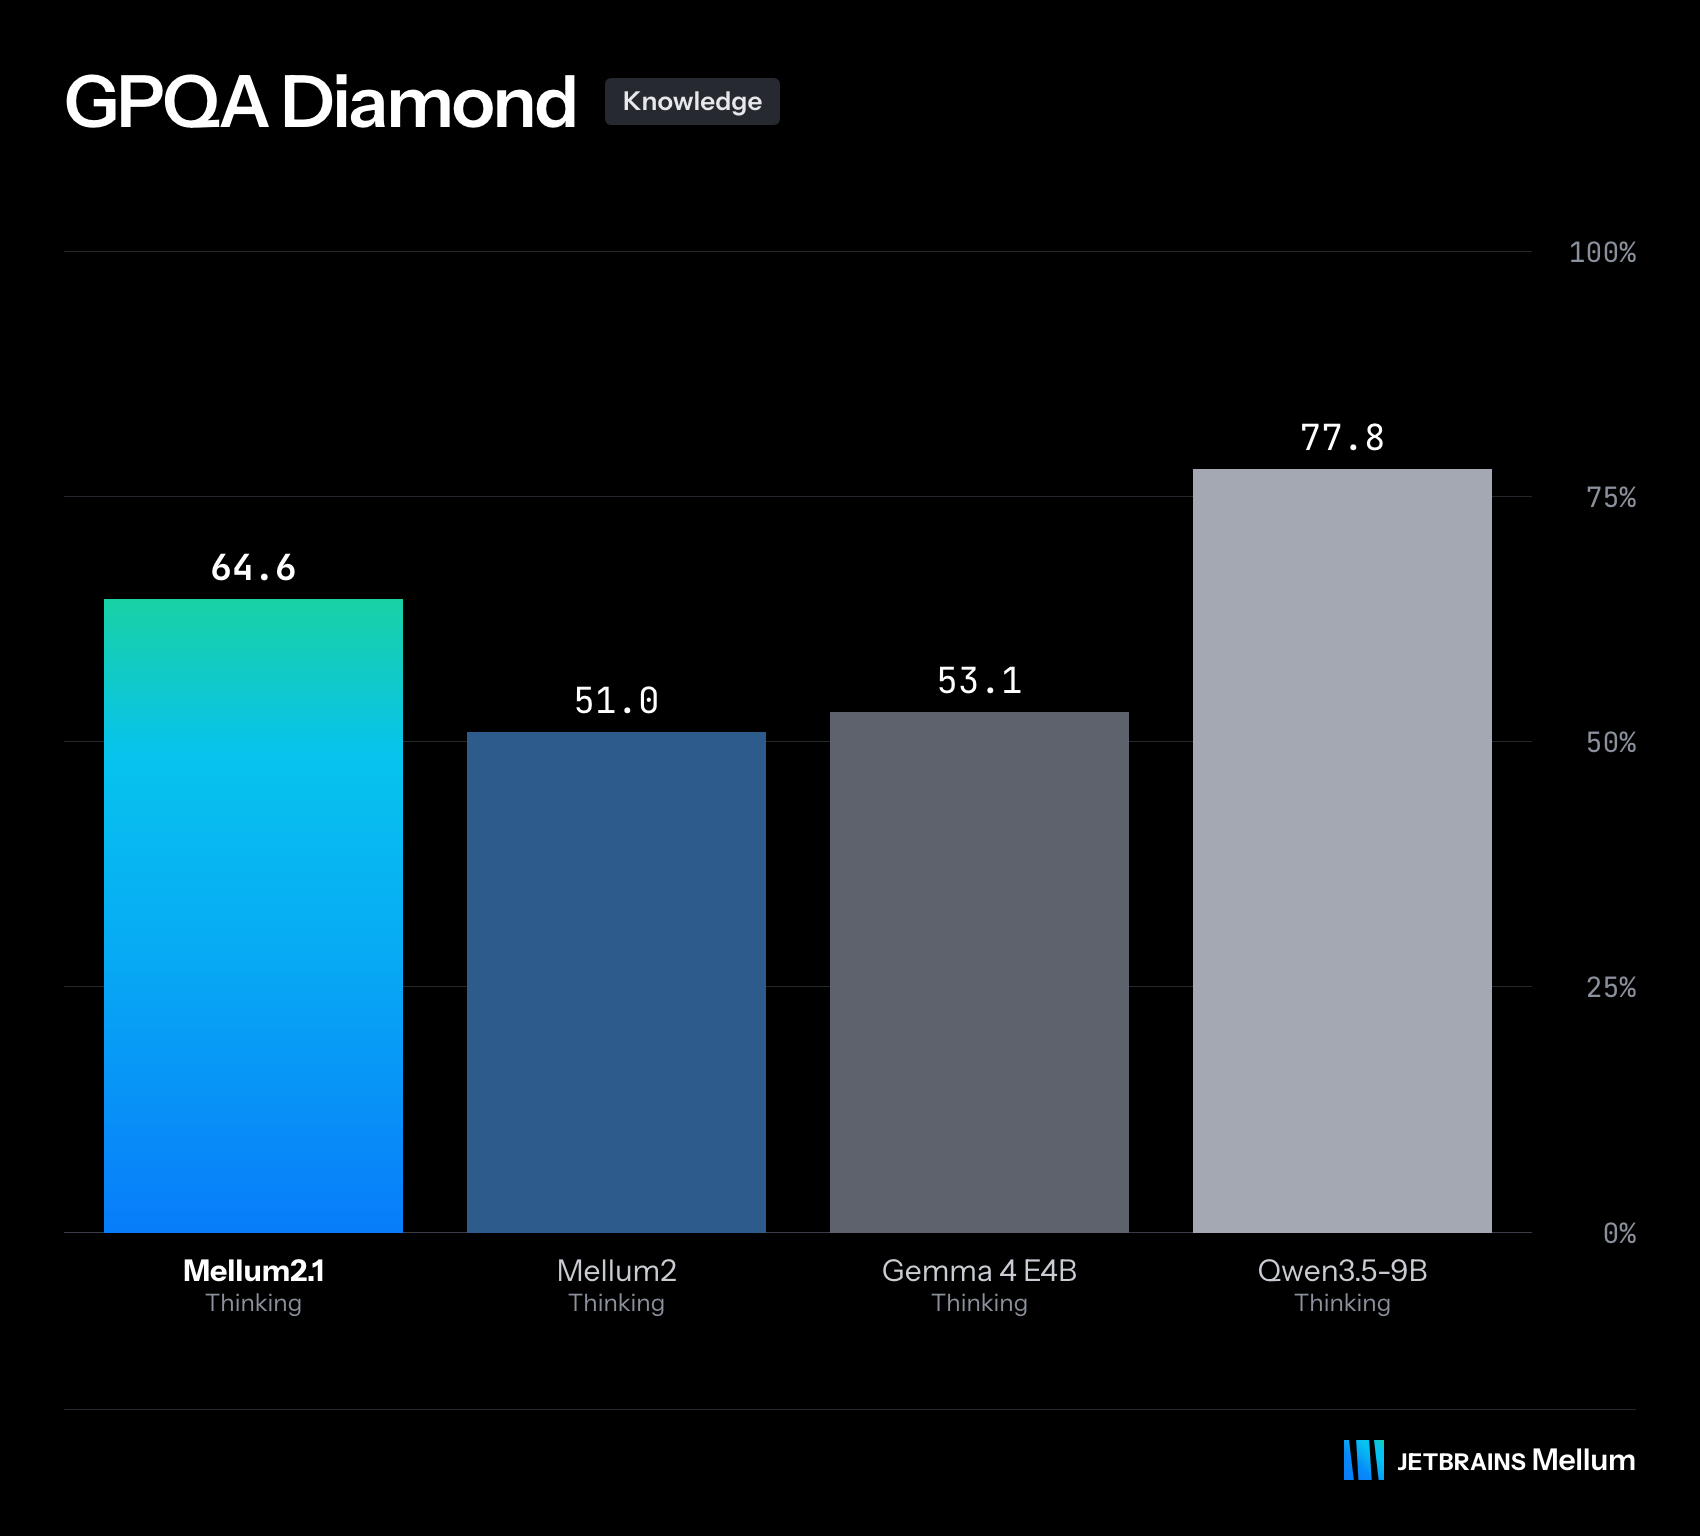
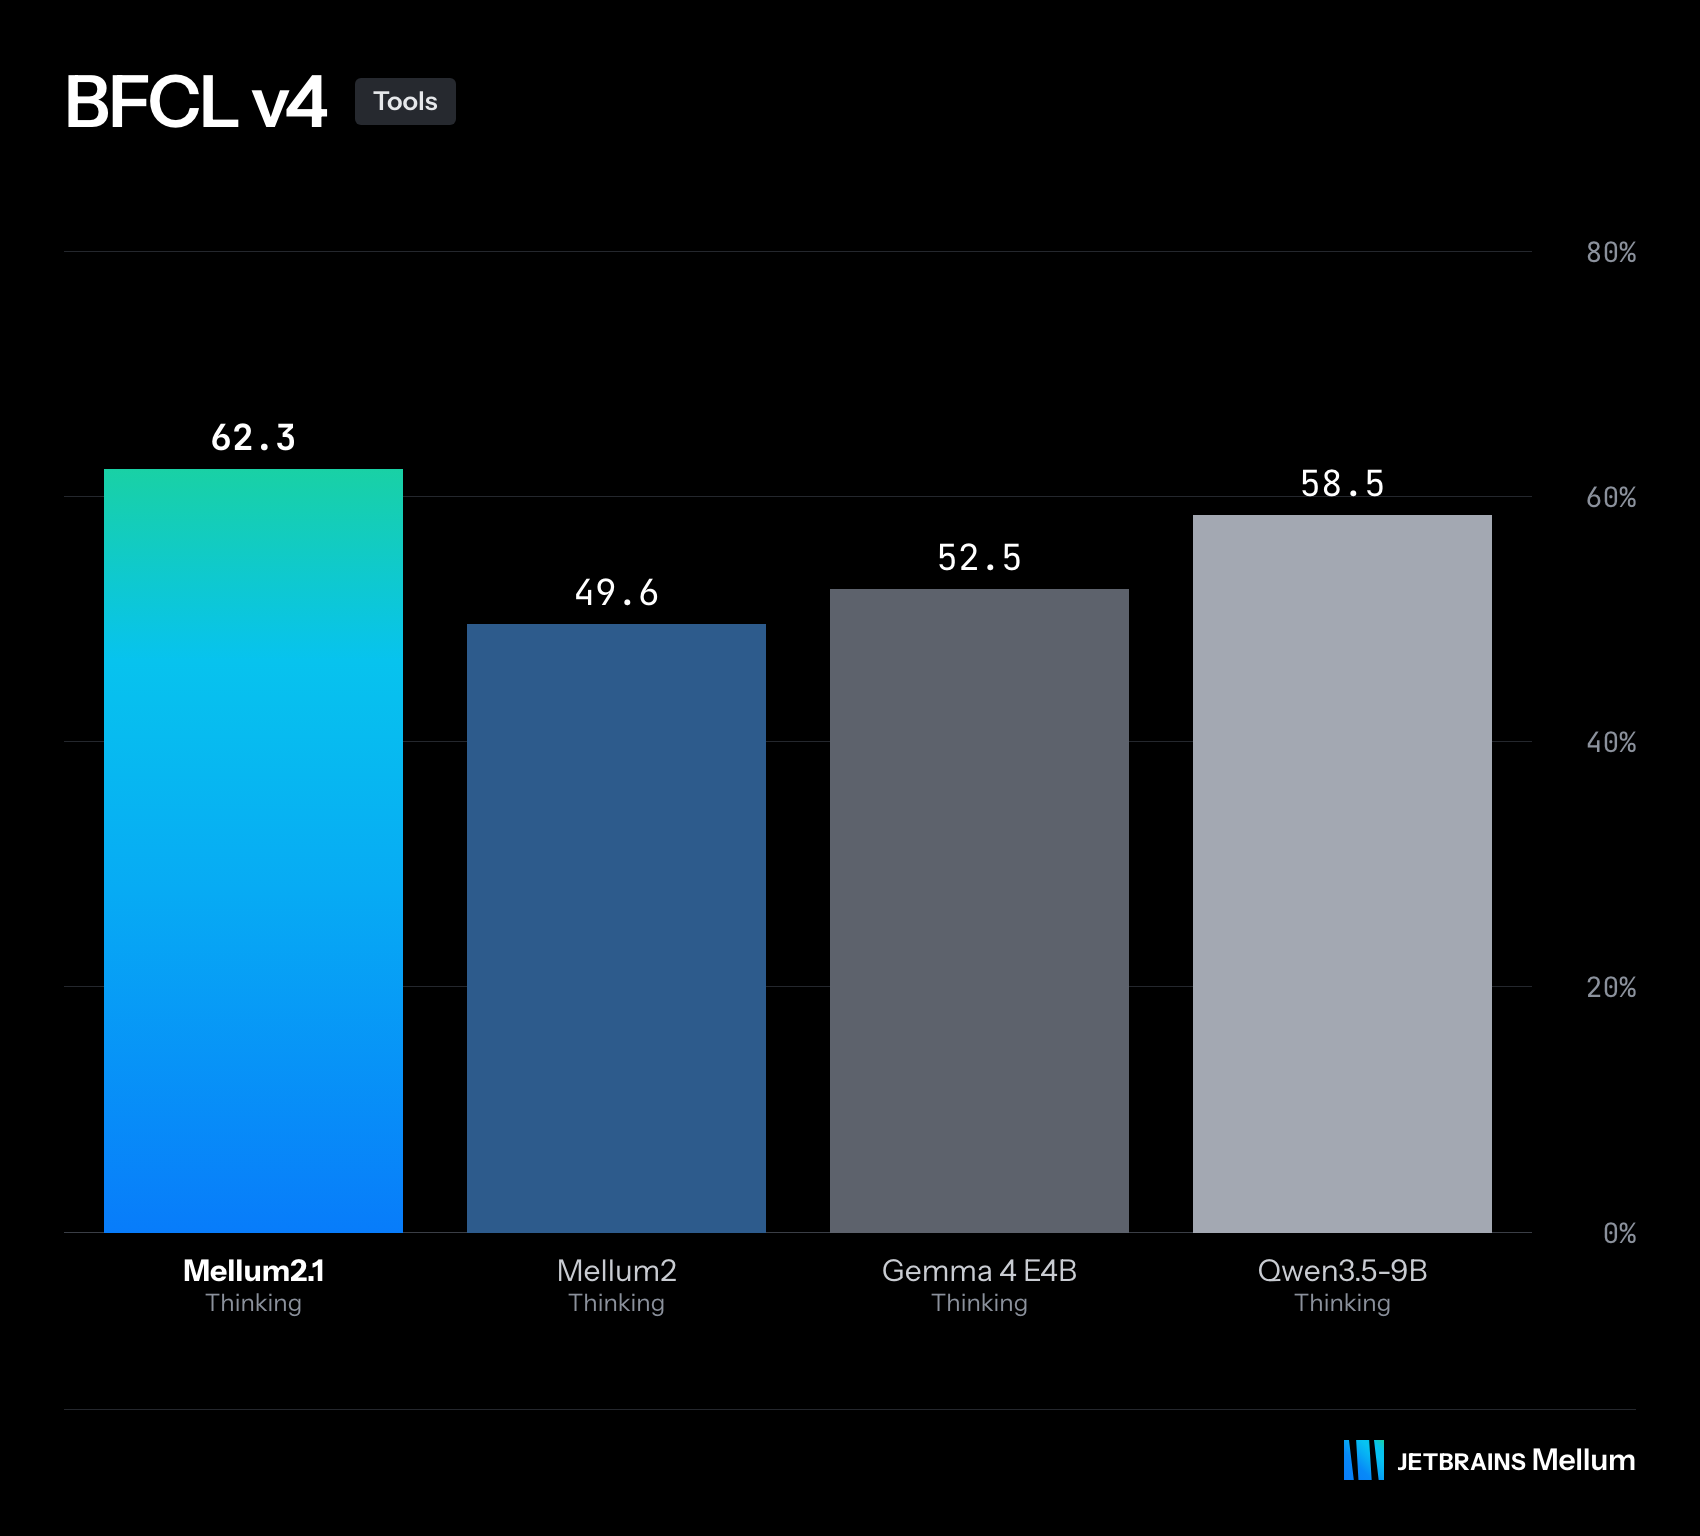
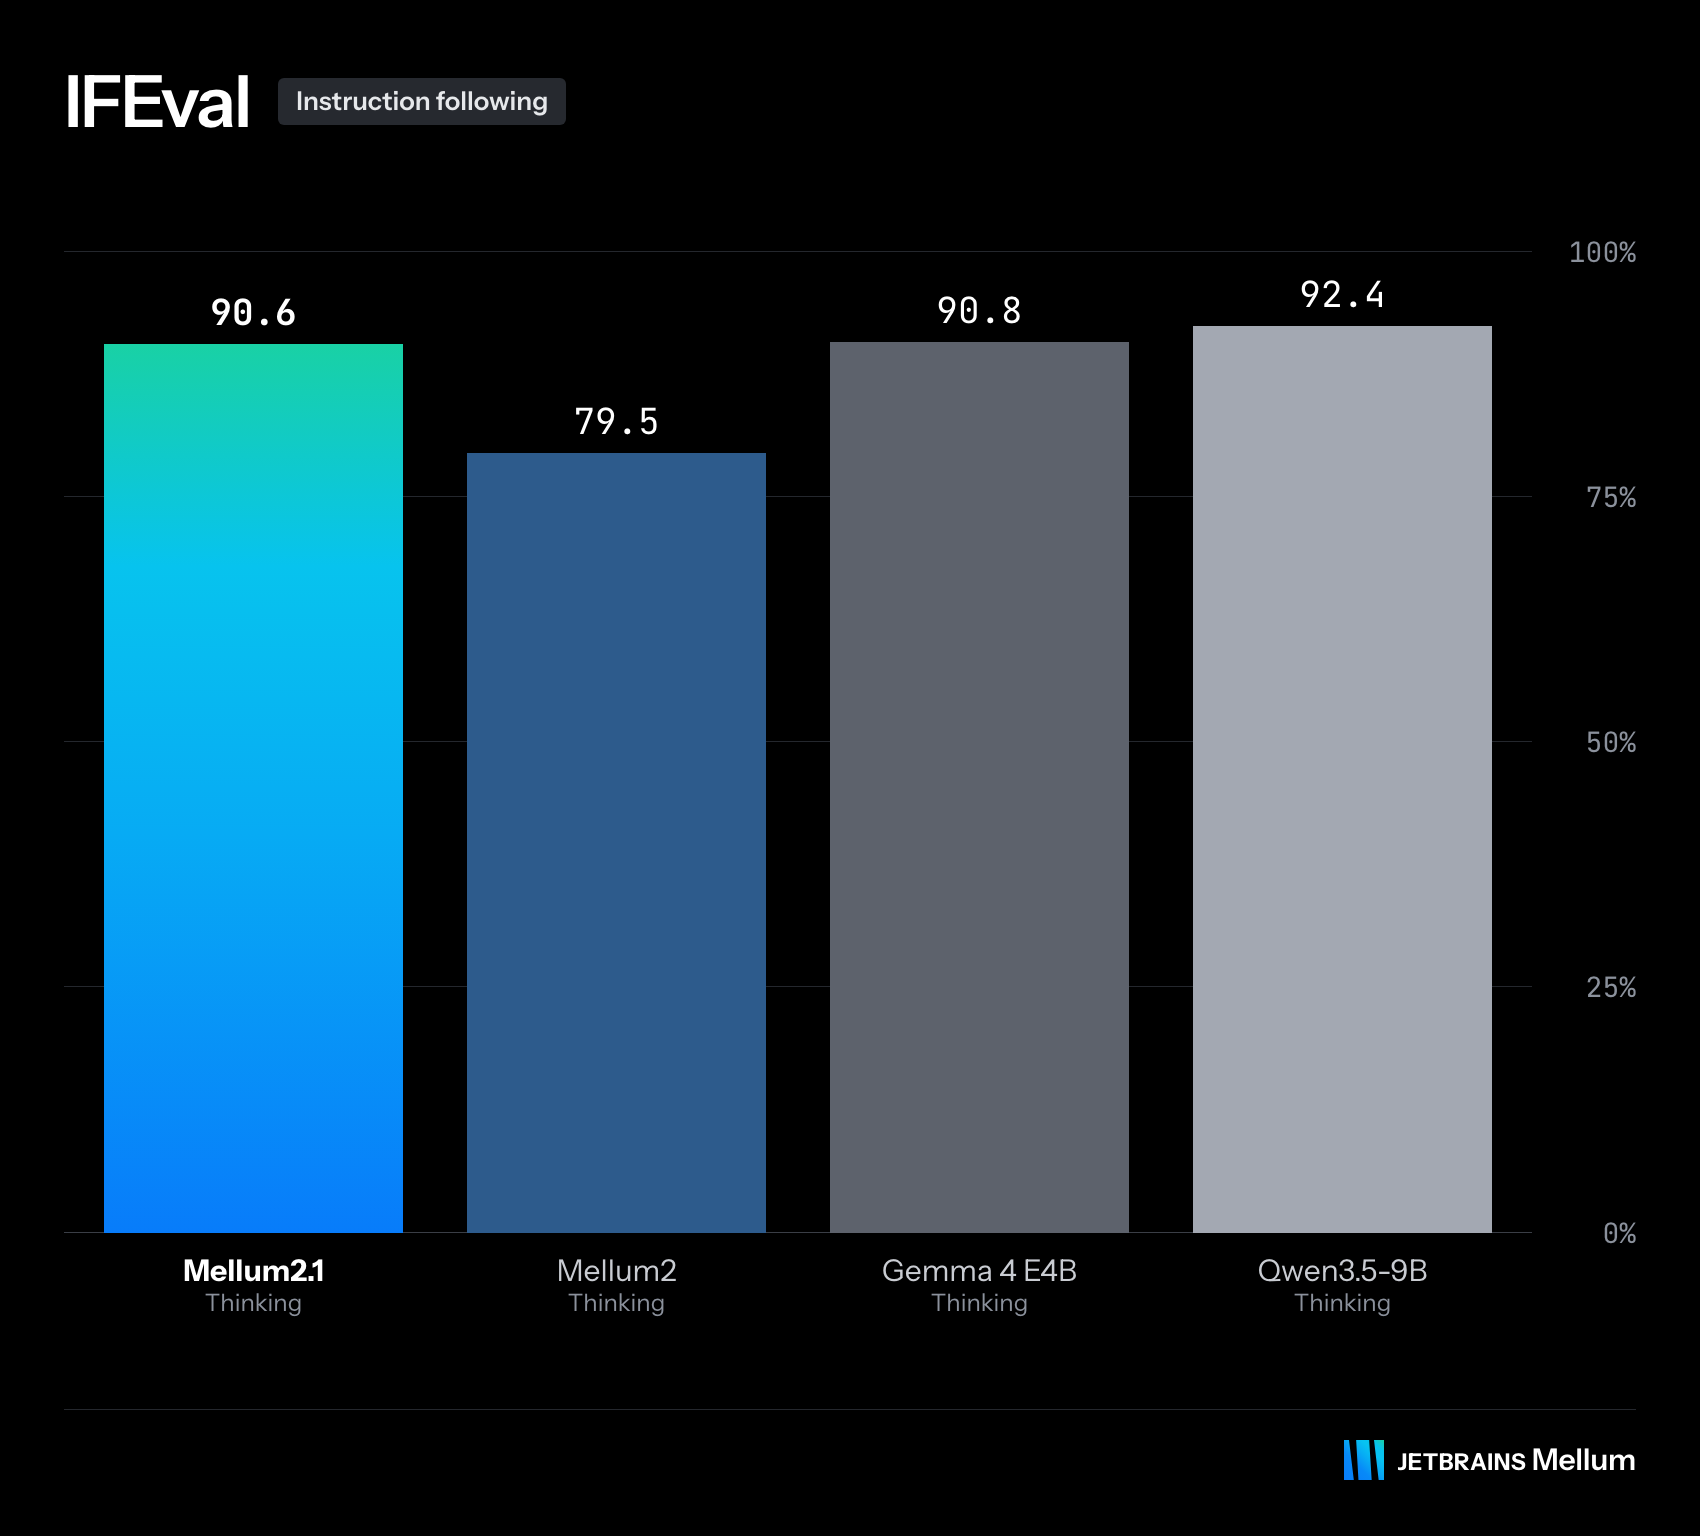
我们将 Mellum2.1 与 Mellum2,以及两个同类开源模型 Qwen3.5-9B 和 Gemma 4 E4B 进行了比较,并对它们使用相同的评估设置。
[LOADING...]
最大的提升在智能体编程方面,与 Mellum2 相比,Mellum2.1 在这一领域进步最大。该模型在各方面也都有提升,在编程、竞赛编程、数学、工具调用和通用知识方面均取得进步,并且无论是在难题还是日常问题上都表现稳健。
[LOADING...]
[LOADING...]
[LOADING...]
[LOADING...]
[LOADING...]
[LOADING...]
速度
后训练没有触及架构,因此 Mellum2.1 与 Mellum2 一样快,而多 token 预测(MTP)让它更快。
在高负载下,Mellum2.1 是该组中最快的模型,服务的 token 数量几乎是 Qwen3.5-9B 的两倍。对于单个请求,MTP 使其速度提升约 1.6 倍。
[LOADING...]
Mellum2.1 的关键用例
- 智能体系统中的得力工作者: Mellum2.1 可以处理智能体计划中的不同环节,从找出失败测试的根本原因,到起草并检查修复方案。
- 编程之外的问题: Mellum2.1 也是一个能力出色的通用助手。它能处理日常问题,并逐步解决困难的数学和推理问题。
- 私有、自托管部署: 在本地或你自己的基础设施上运行 Mellum2.1,让代码和数据完全由你掌控。
开始使用 Mellum2.1
Mellum2.1 已在 Hugging Face 上提供。适用于 llama.cpp、Ollama 和 LM Studio 的 GGUF 构建,以及用于 vLLM 中推测解码的多 token 预测(MTP)头,即将推出。
如果你正在构建运行在自有基础设施上的编码智能体、子智能体或 AI 工具,我们非常希望你试用 Mellum2.1。告诉我们哪些有效、哪些无效。你的反馈将塑造下一个版本。
开源是打造更好模型的方式。