更小巧、更快速的Java服务器:采用Spring风格API
[LOADING...]
你为 Spring 和 Java 的动态架构付出了什么代价?能否在不承担同样运行时成本的情况下提供相同的 API? | Codename One 是什么? Codename One 是一个开源框架,可用单一 Java 或 Kotlin 代码库构建原生 iOS、Android、桌面和 Web 应用。了解更多请访问 codenameone.com。
对于小型服务,你可能希望拥有依赖注入、事务和定时任务,而不必忍受冗长的启动时间或庞大的部署包。这正是我们的原生 Java 后端试图实现的目标。编写一个控制器和一个服务,将它们的装配编译进应用程序,然后部署一个原生可执行文件。
该 API 底层的 HTTP 运行时很小。在下面的双核 Linux 测试中,其较低层级的 Bench 处理器占用 5.17 MiB,并在 14.8 ms 内达到首次验证响应。Spring/GraalVM 中相同的两个端点占用 88.31 MiB,响应时间为 43.6 ms。该处理器不使用控制器注解或生成的装配,因此这些数字衡量的是 HTTP 栈,而不是 Spring 风格 API 的成本。
本周的 Spring 风格 API 增加了那些让该方法在问候端点之外变得有用的部分:事务传播、作用域 Bean、后台任务、会话、指标和 MCP 工具。ParparVM 提供原生运行时,包括虚拟线程,可在处理器等待 PostgreSQL、MySQL 或其他 HTTP 服务时挂起。
这是一个 Spring 风格的 API,而不是可直接替换的 Spring 实现。 它的注解位于 com.codename1.backend.annotations。Spring 本身支持 AOT 处理和 GraalVM Native Image。我们的主张是更小的受支持面、直接生成的调用、与我们的应用框架共享的原生运行时,以及当你想知道某个注解的成本时可以检查的代码。
该后端仍在开发中。它基于 ParparVM,这是我们原生 iOS 应用背后的运行时,并且正在快速成熟。下面的本地测量显示了它在哪些方面配得上“更小、更快”的描述。它们也定义了所比较的狭窄工作负载。
本周预告
今天的文章涵盖后端 API、生成的代码和本地服务器比较。后续文章将探索本次发布其余部分能做什么:
- 10 月 3 日星期六: 亲爱的,我把 Java 缩小了。对象头、编译器优化和垃圾回收如何影响应用程序所需的内存和 CPU。
- 10 月 4 日星期日: 你能分辨这些 iOS 标签栏的区别吗?。比较视频,然后了解测量得到的运动和玻璃公式如何让你的 UI 更接近 UIKit。
- 10 月 5 日星期一: 你更喜欢 Gradle 吗?。从更少的文件开始,构建独立后端,找到合适的 Javadoc,并尝试单独的 Android Gradle 9 选项。
- 10 月 6 日星期二: 将你的应用连接到企业追踪。将你的客户端应用和原生后端连接到跨企业服务的追踪,同时还有指标和 MCP。
- 10 月 7 日星期三: 你想让你的 Web 应用感觉像原生应用吗?。在浏览器中使用桌面主题和可见菜单。证书向导也获得相同的主题系列。
- 10 月 8 日星期四: 周一别点鱼,周五别发布。在提交前捕获私有 API 导入,以及一次艰难的周五发布教给我们的测试缺口。
比较启动、内存、吞吐量和构建时间
测量使用 CN1 修订版 60c4f310。为了进行比较,我们在 Linux 部署目标上运行了两个小型 HTTP 处理器:一个 13 字节的纯文本响应和一个包含一个 message 字段的 JSON 对象。CN1 可执行文件使用仓库中较低层级的 Bench 处理器。Spring Boot 4.1.1 使用 Spring MVC 和嵌入式 Tomcat,运行在 Temurin JDK 25 上,或作为 GraalVM 25 原生可执行文件运行。
这比较的是所选的 HTTP 栈,而不是等效的框架功能。 CN1 处理器并未使用下面展示的注解生成的应用程序。两个应用中都没有数据库、TLS、身份验证或遥测。两个 JSON 处理器都会为每个请求创建一个 map;CN1 还会分配一个新的响应对象。
主机是 Apple M4 Max,具有 16 个逻辑 CPU 和 64 GiB RAM。本地 Linux ARM64 虚拟机有四个虚拟 CPU 和 8 GiB。Linux CPU 亲和性将服务器限制为 1、2 或 4 个 CPU。在 1 和 2 时,负载生成器在剩余的 CPU 上运行;在 4 时,它与服务器共享 CPU。这些是实际的调度限制,而不仅仅是报告的处理器数量。
快速启动并交付更小的可执行文件
双核配置为服务器和负载生成器提供单独的 CPU。以下是三个新进程的中位数,启动范围在括号中:
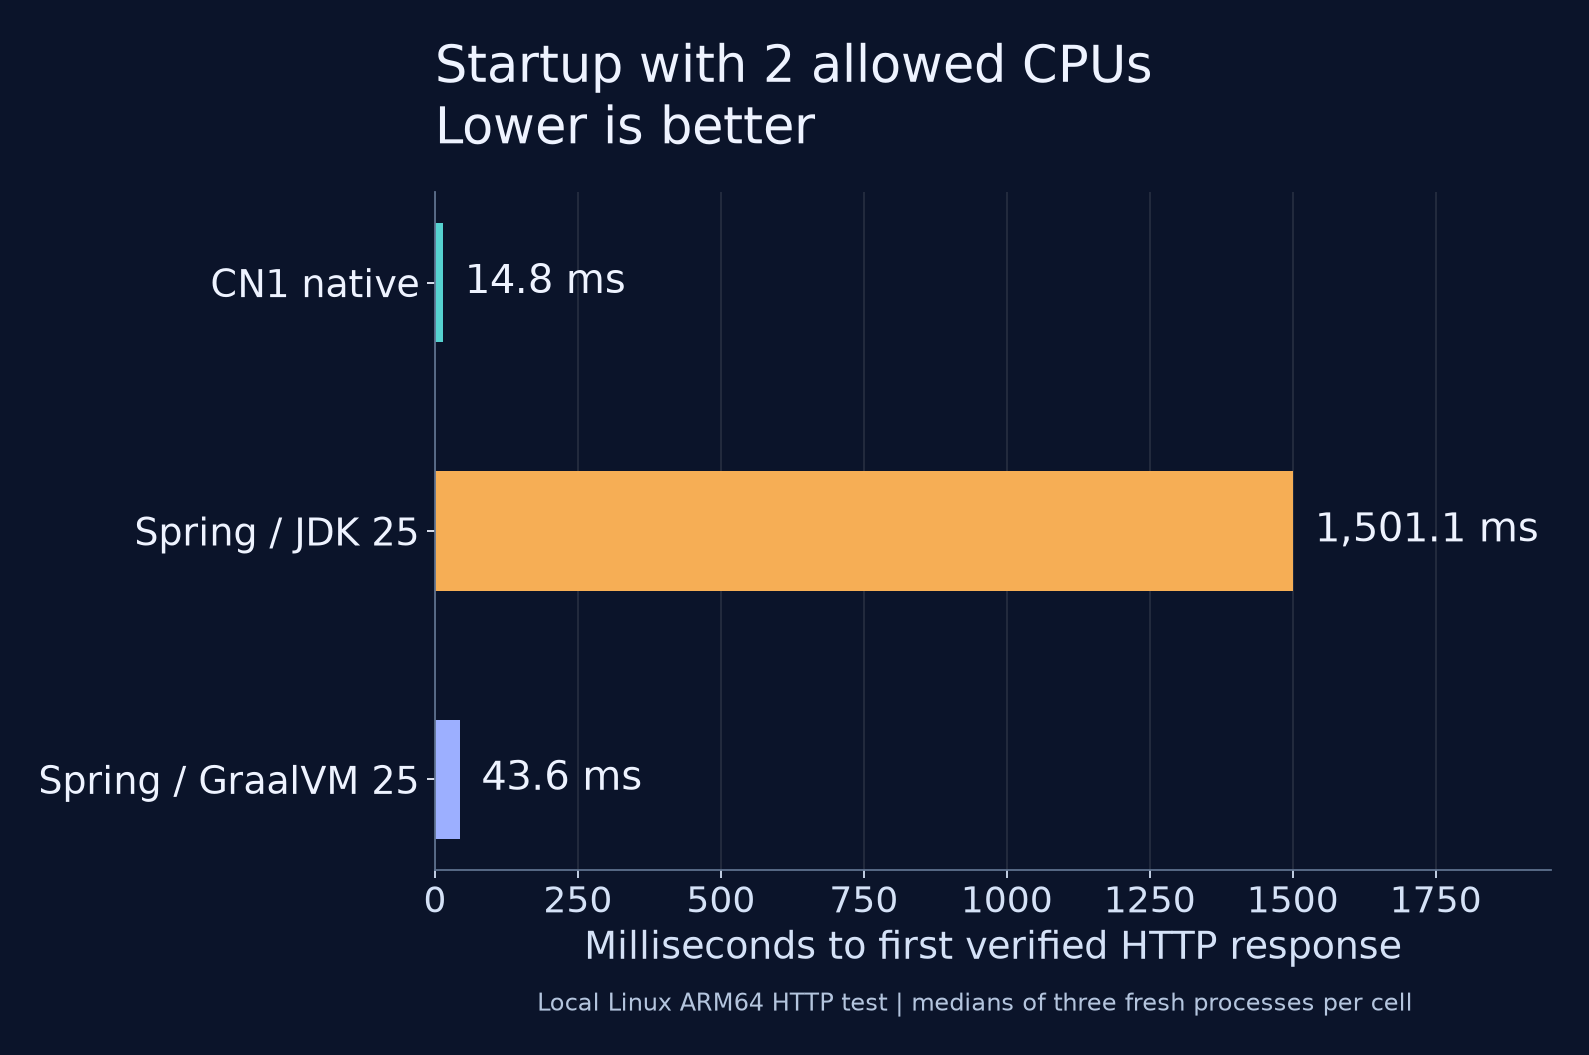
启动包括生成进程和接收经过验证的 HTTP 响应。文件系统缓存保持热状态;这不是冷机器或无服务器测量。轮询循环和 taskset 启动器也贡献了较短的原生时间。JVM 运行使用其默认运行时设置,没有 AOT 缓存。
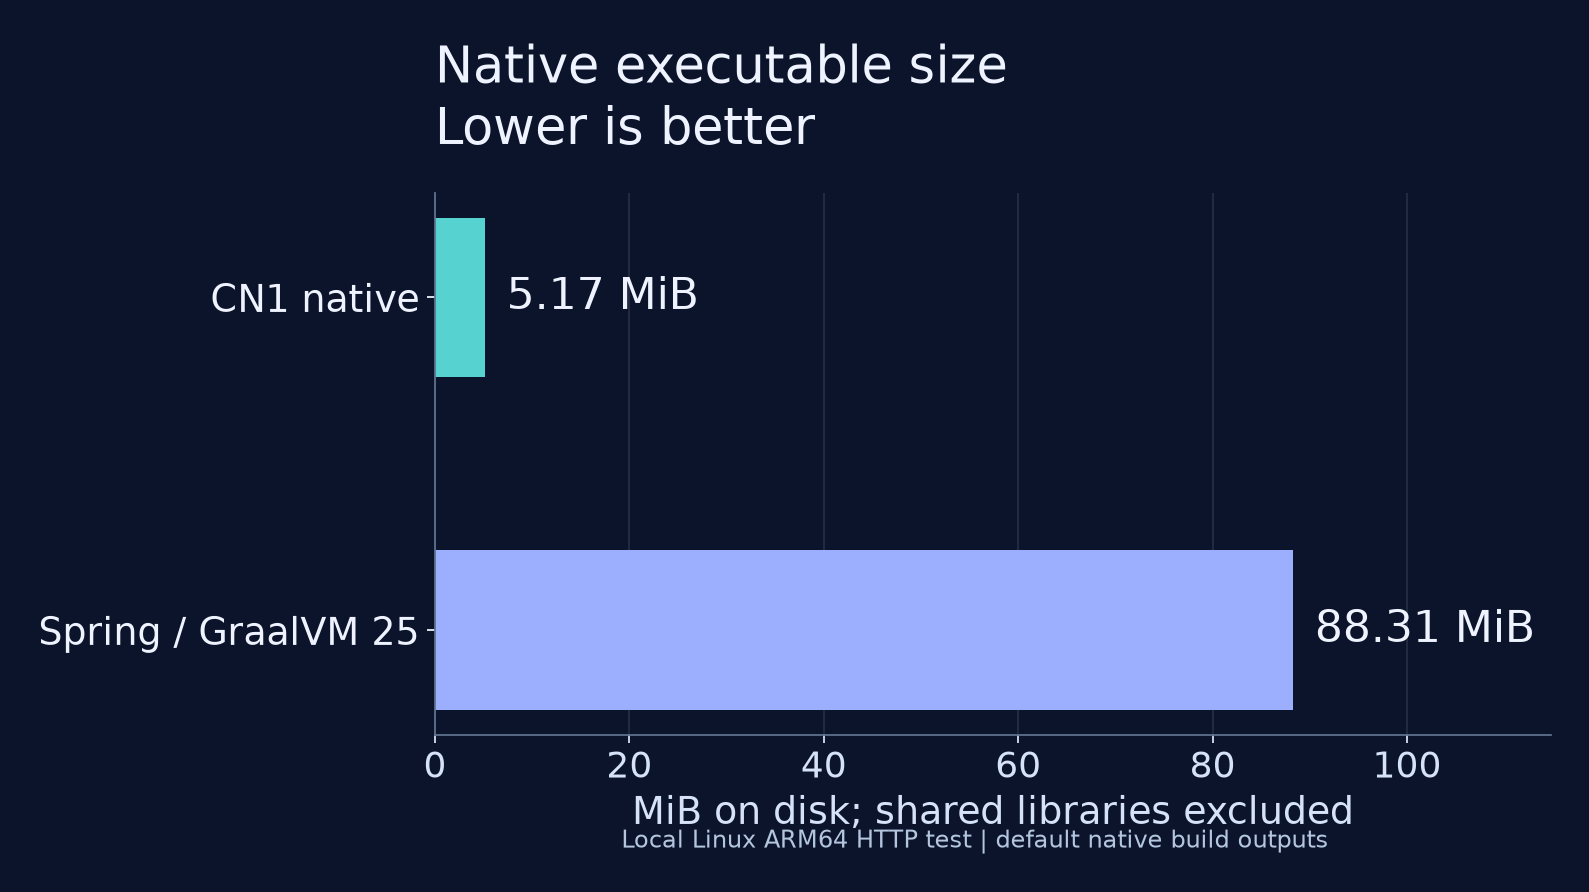
CN1 可执行文件为 5.17 MiB,而此 Spring 原生构建为 88.31 MiB。这些是来自默认构建输出的未压缩可执行文件。两个文件在经过额外的符号剥离后都没有变化。两个构建都使用共享系统库,这里不包括它们。这不是容器大小或完整部署的比较。JVM 列显示为不适用,因为其 JAR 不是独立的原生可执行文件。
为你的服务所做的工作留出更多内存
服务器在开始接受流量后,内存使用会发生变化。我们为每个运行时使用相同的时间窗口记录了所有三个阶段:
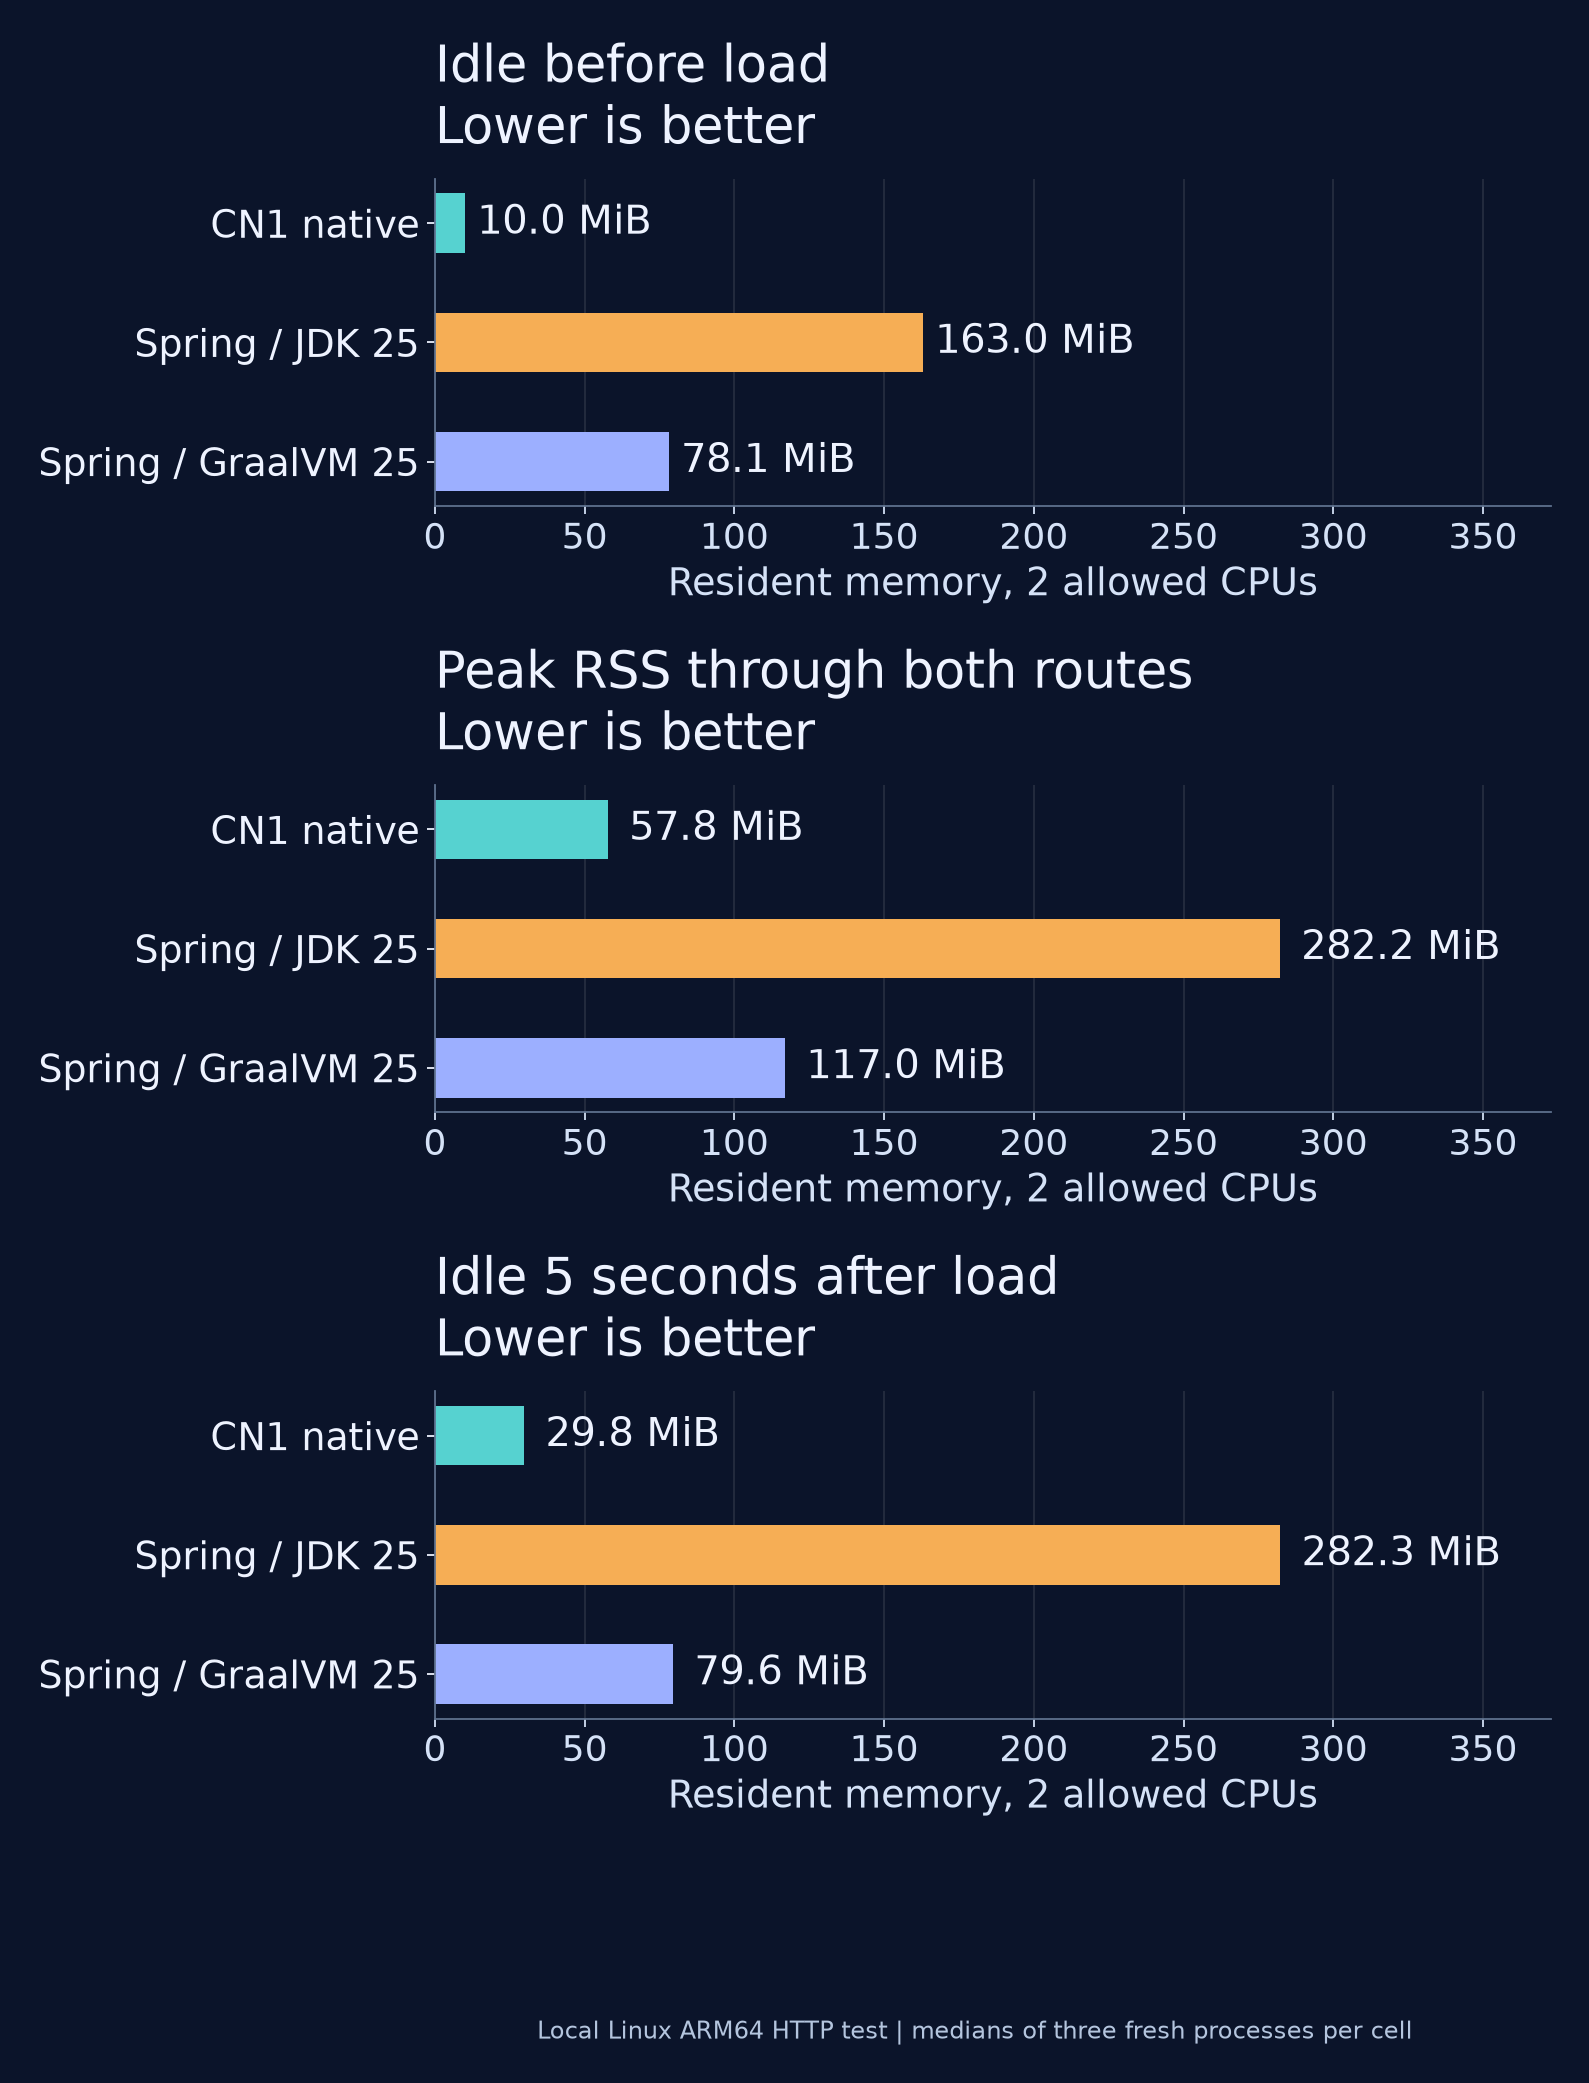
在所有三个内存列中,越低越好。负载前空闲在首次验证响应后三秒采样。峰值是内核在启动和两个路由期间的常驻内存高水位标记。负载后空闲在流量结束后五秒采样,不强制回收。每个表项是三个进程测量值的中位数。
在这里的空闲和负载测量中,CN1 使用的常驻内存都更少。四字节对象元数据只是该成本的一部分。RSS 还包括代码、栈、分配器页和库状态;它不是活动 Java 堆。此 Linux 构建使用原生虚拟线程,因此其连接成本与平台线程池不同。
使用 1、2 或 4 个 CPU 服务请求
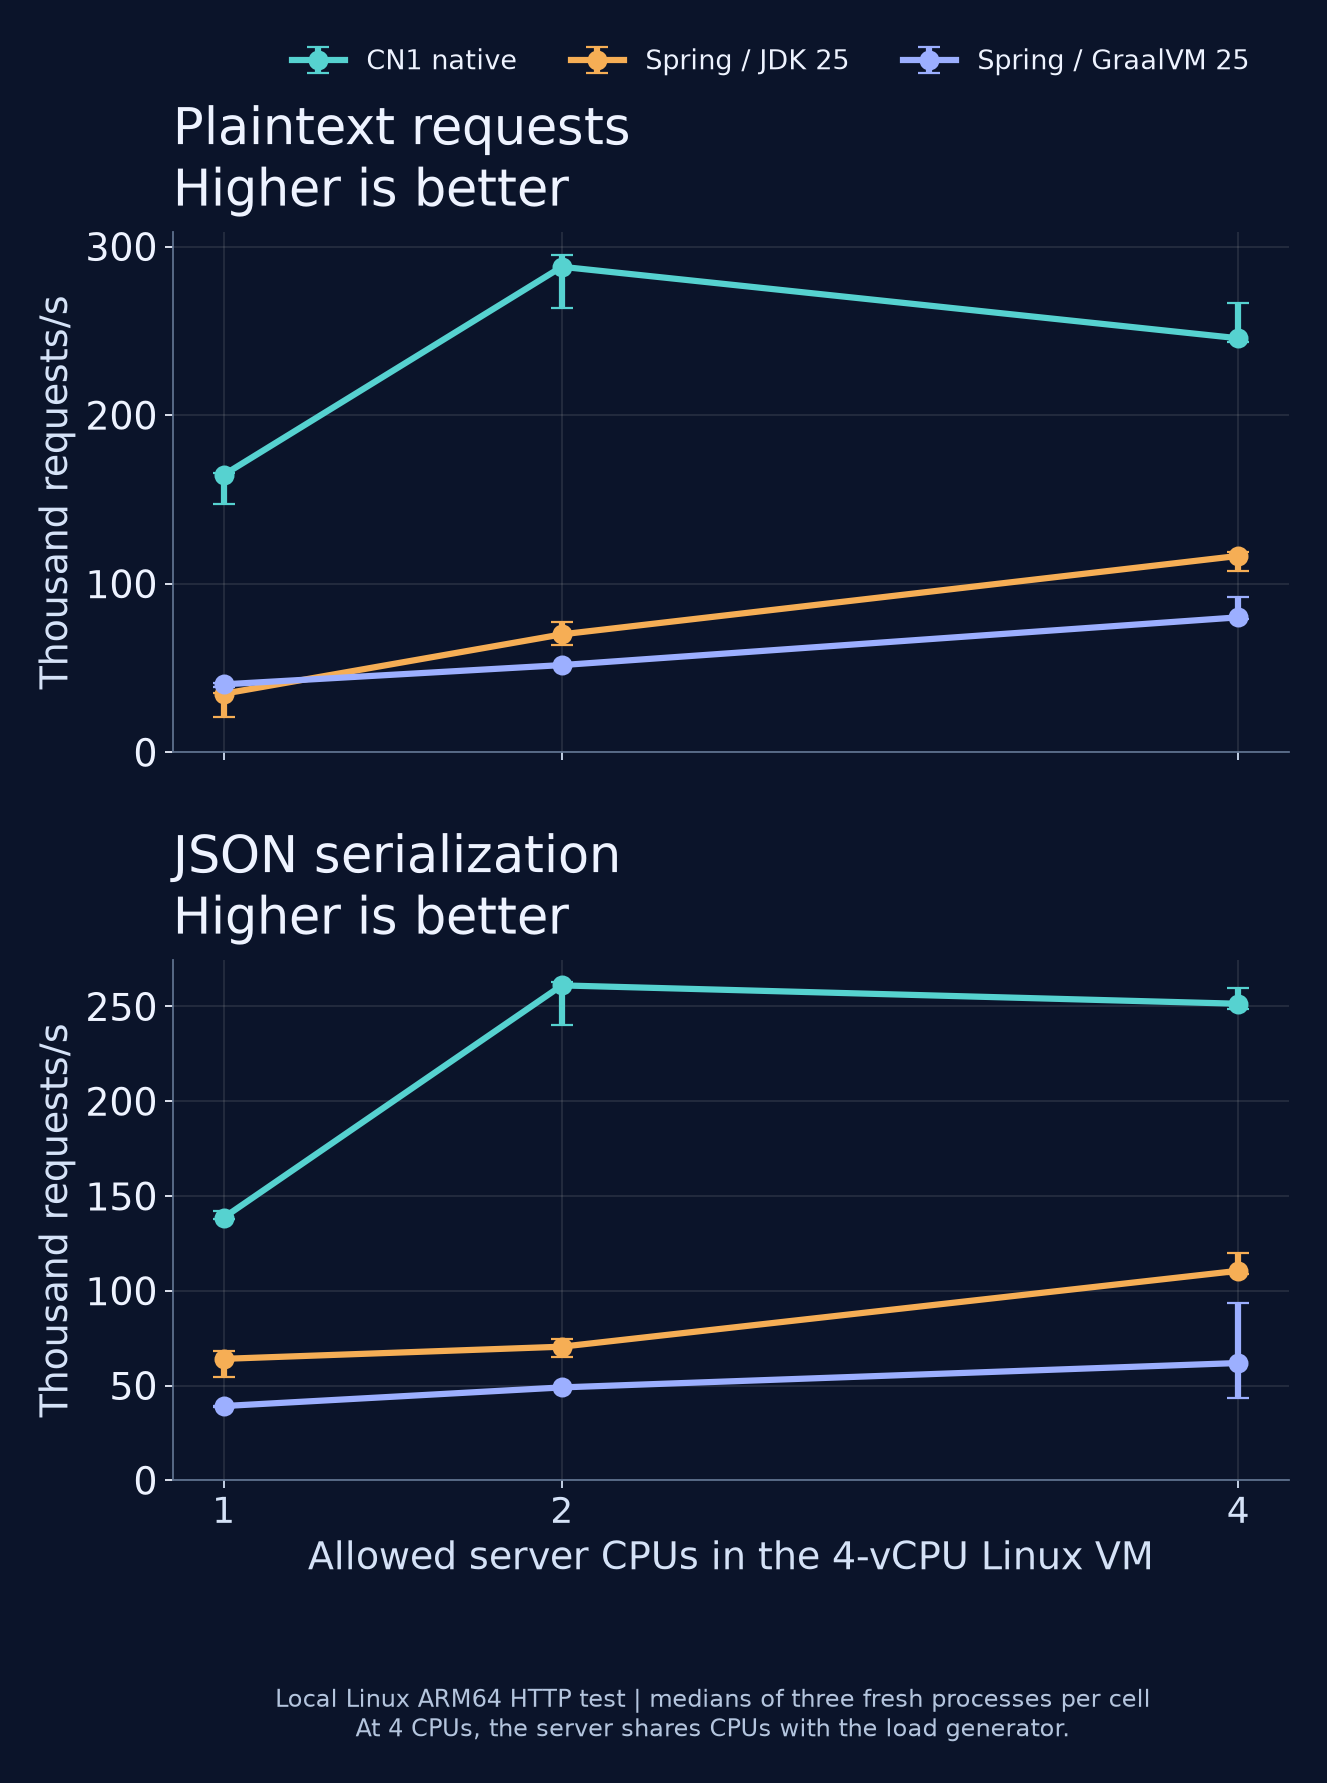
越高越好。点是中位数;须线显示三次运行的范围。每个路由有十秒预热和十秒测量,使用两个 wrk 线程和 32 个连接。纯文本先于 JSON。四核点包括负载生成器争用,因此这不是干净的四个核扩展曲线。
HotSpot 在预热后能追上吗?
在每个端点预热一分钟后,CN1 仍然领先:在匹配的双核后续测试中,其纯文本吞吐量是 Spring/JDK 25 的 3.9 倍,JSON 吞吐量是 3.4 倍。两台服务器都接受了相同的更长预热,然后每个路由连续进行三个十秒测量窗口。
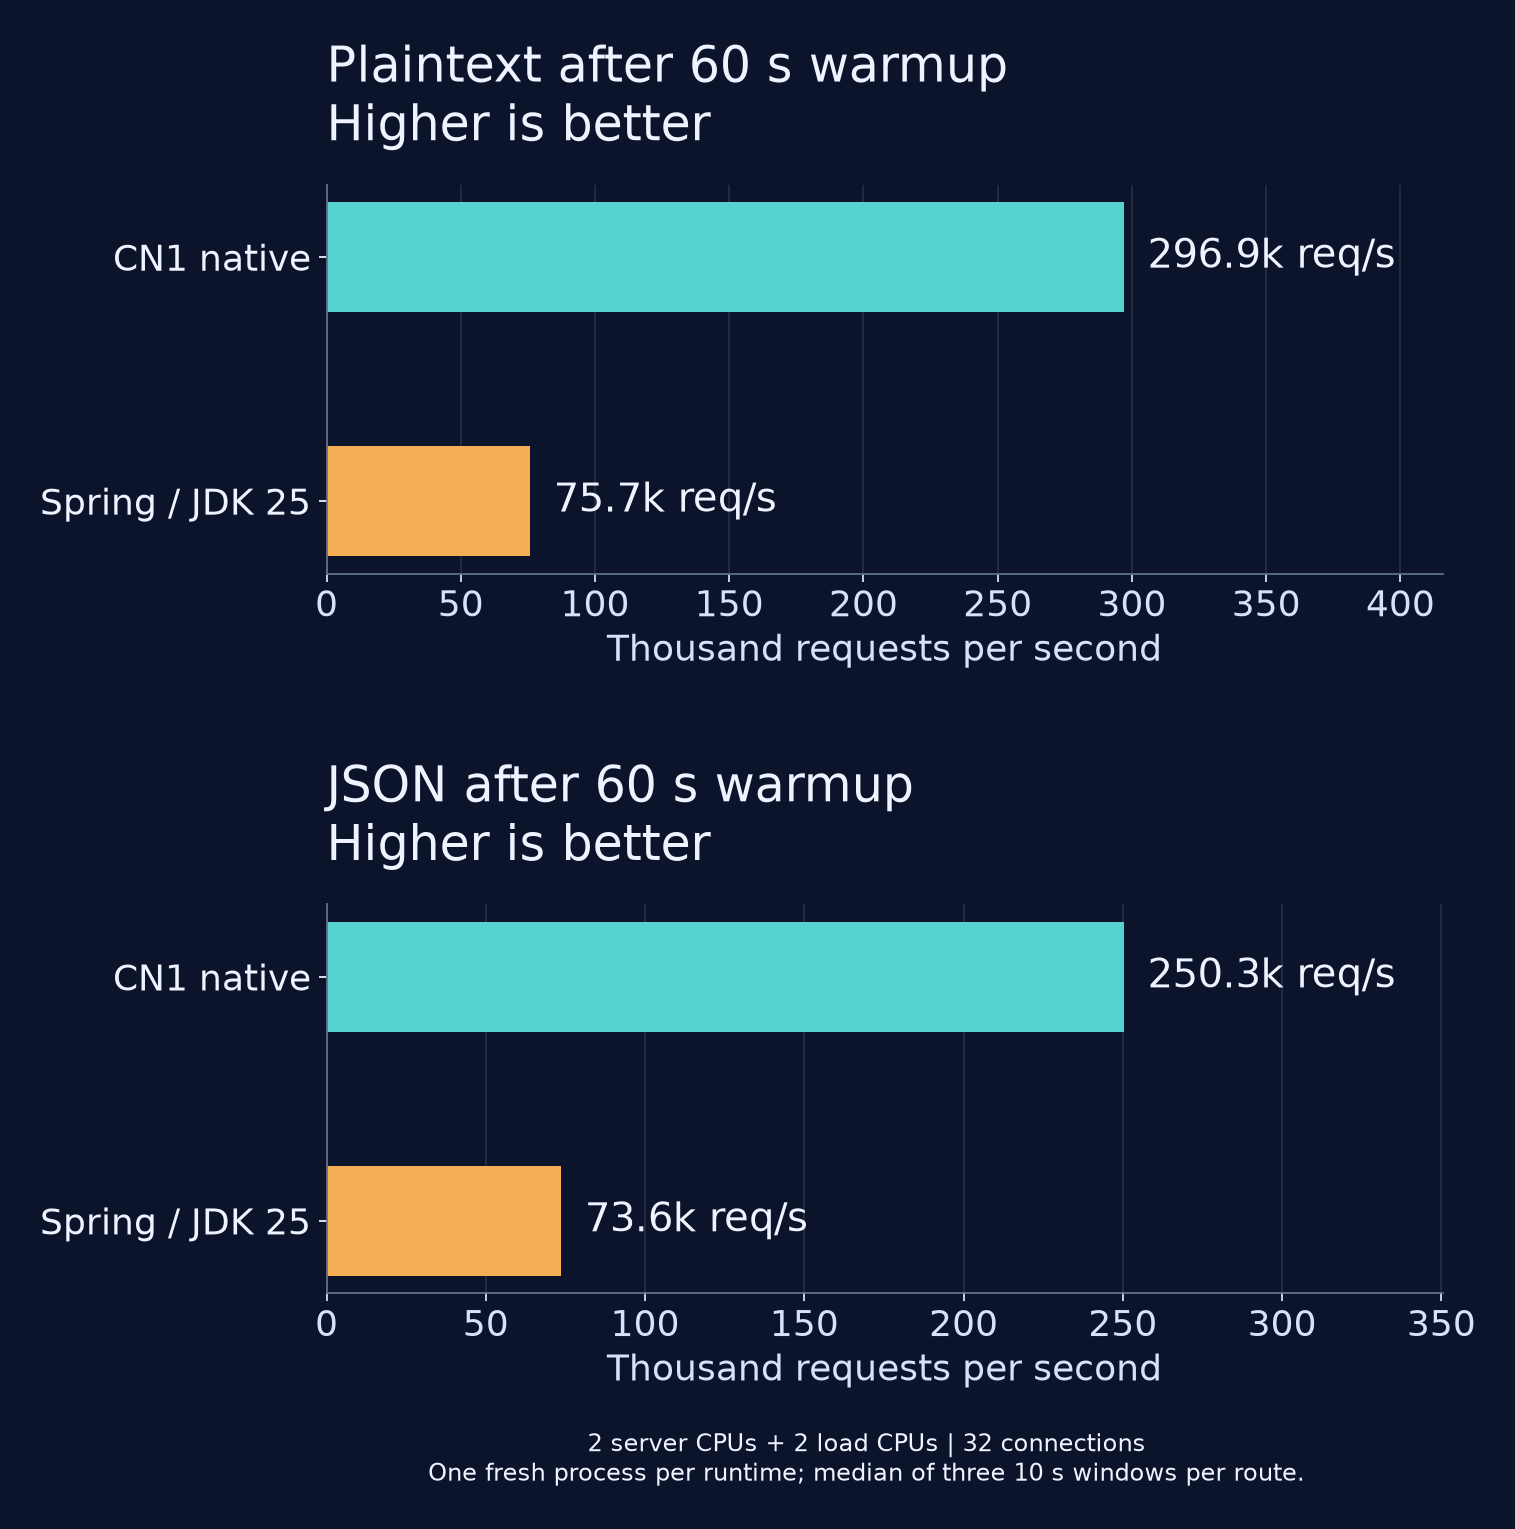
越高越好。这些是每个运行时在一个新进程内的三个窗口的中位数,与上面的三进程矩阵分开。服务器使用 CPU 0 和 1;wrk 使用 CPU 2 和 3,32 个连接。两个路由都完成,没有套接字或非 2xx 错误。
我们在预热期间检查了 HotSpot 的编译方法列表:Spring 的请求分发器和处理器适配器已达到第 4 层编译。快照包含在复现包中。额外的预热并没有为这两个处理器缩小差距。更复杂的应用代码、依赖项和不同的并发级别可能会改变这种比较。
该矩阵轮换运行时顺序,并在中间轮次反转 CPU 顺序。每个响应体在负载前都会检查;预热或测量期间任何套接字或非 2xx 错误都会使该次运行无效。所有 27 次进程运行都完成,没有这些错误。两台服务器上的 keep-alive 请求限制都已提高或禁用;其他运行时设置使用默认值。
构建需要等多久?
原生编译将工作从启动阶段转移到构建阶段。你不需要在每次编辑后都付出这个成本:CN1 的调试/开发模式在 JVM 上运行,而原生构建生成部署可执行文件。
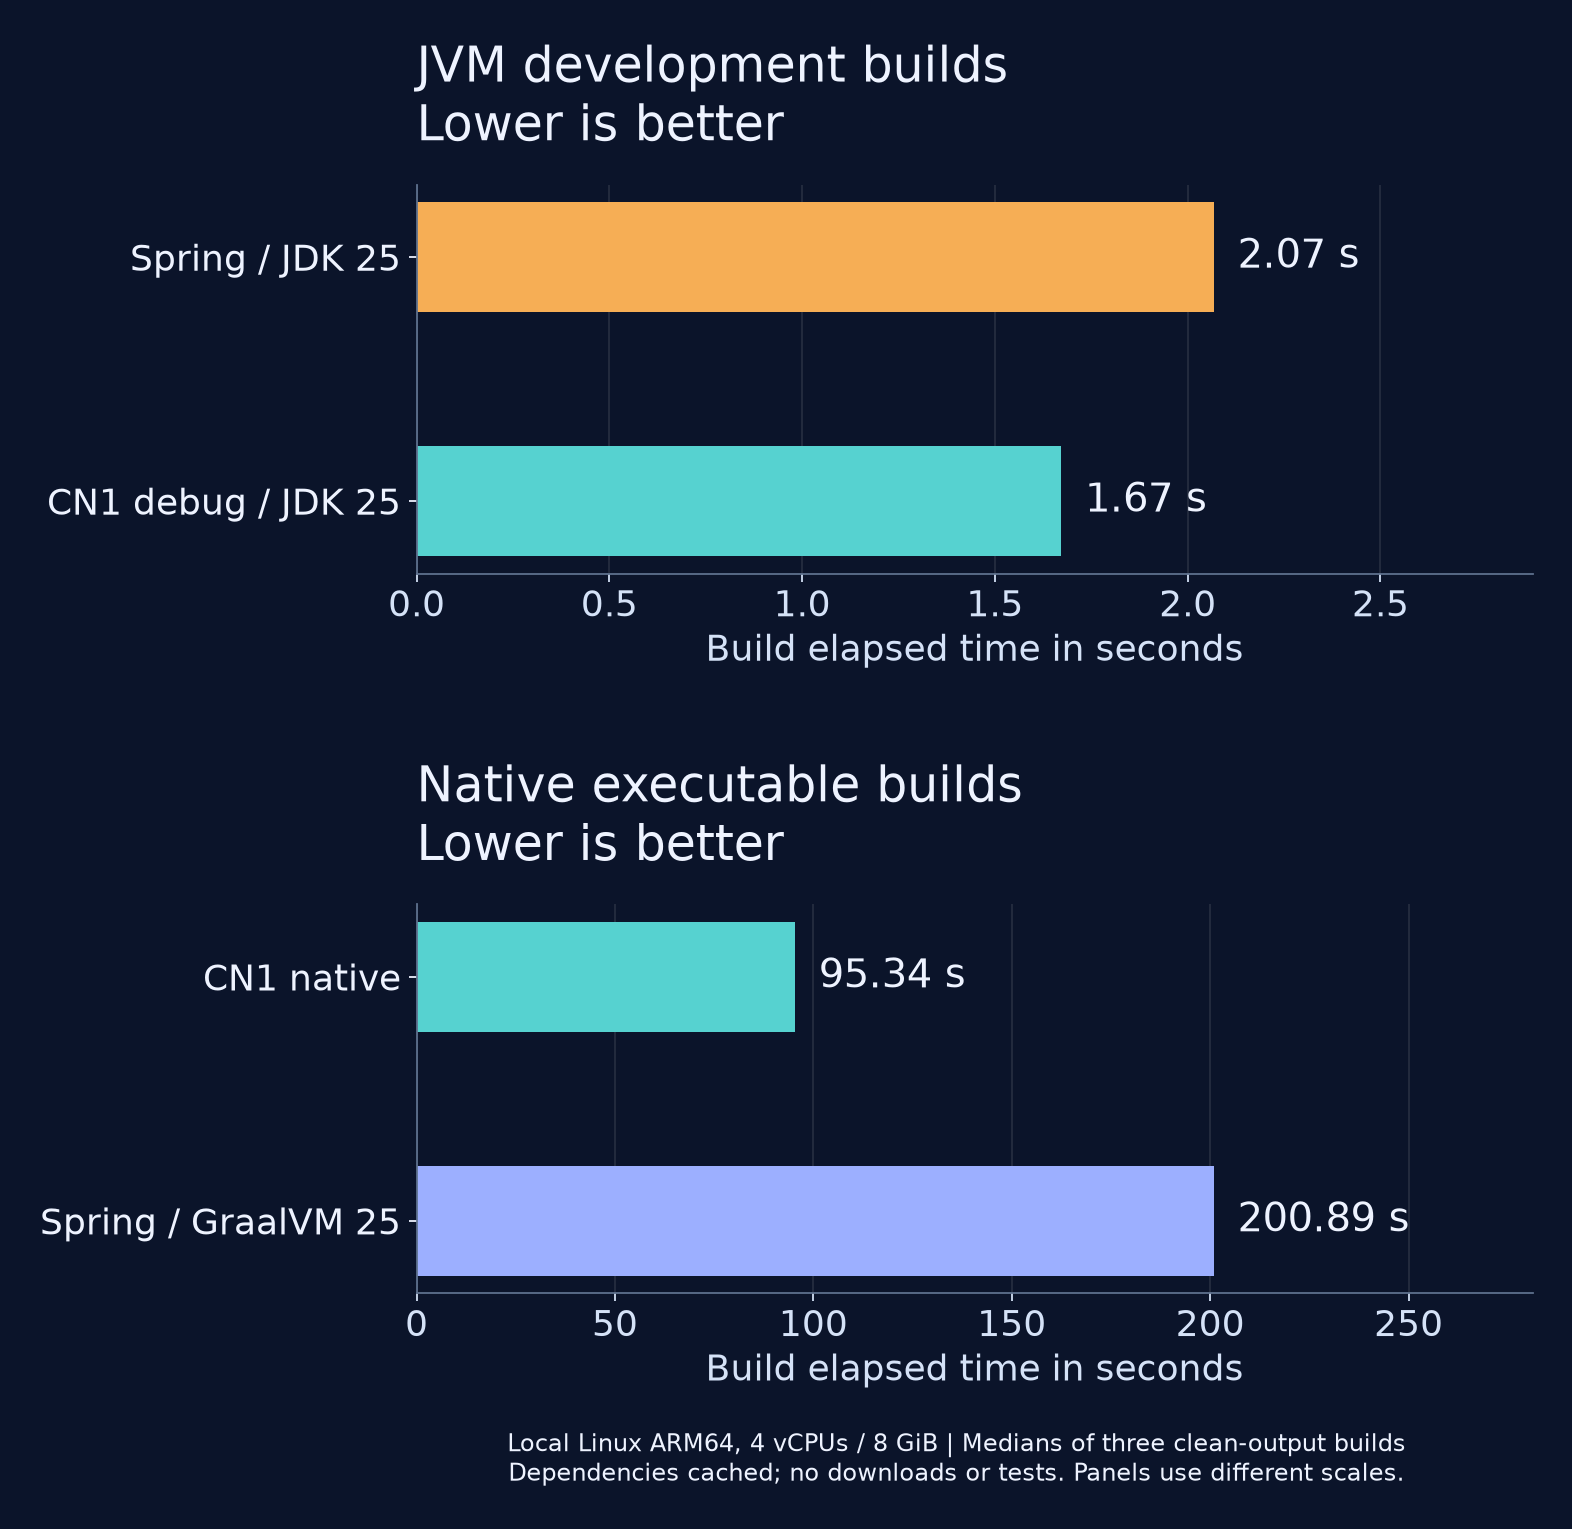
越低越好。每种配置三次构建,运行时顺序轮换,在同一个四 vCPU、8 GiB Linux 虚拟机上。每次都会重新构建应用程序输出;依赖项和工具链被缓存。下载、测试和服务器启动不包括在内。
对于此示例,CN1 原生构建比 Spring/GraalVM 少用 53% 的耗时。JVM 构建只需几秒。这保持了编辑-调试循环的简短,同时让你在部署前检查原生构建产物。
CN1 开发测量使用 JDK 25 编译仓库的 Bench 处理器、JavaSE 后端运行时和共享源代码。原生路径使用 JDK 8 编译 Java,翻译它,然后用 Clang 在 -O3 下编译和链接生成的 C;翻译器和 Java API 依赖项是预构建的。Spring 在 JDK 25 上使用 Maven clean package;其原生构建添加了 Spring AOT 处理和 GraalVM native:compile。这些是 HTTP 示例的构建路径计时,包括它们不同的构建工具,而不是孤立的 javac 或增量构建计时。
复现包 包含源代码、命令、构建产物哈希、每个原始样本、匹配的更长预热比较、干净输出构建计时以及控制器和事务示例。对于有这些约束的服务,这些结果让小型原生后端值得一试。在用于选择部署容量之前,请测量你自己的处理器和依赖项。
以更少的运行时设置启动你的服务
以下是后端模块的完整控制器:
在 javac 编译你的源代码后,构建会读取注解并生成用于路由、依赖注入和方法插桩的 Java 类。ParparVM 将生成的字节码翻译为 C,然后原生编译器构建可执行文件。
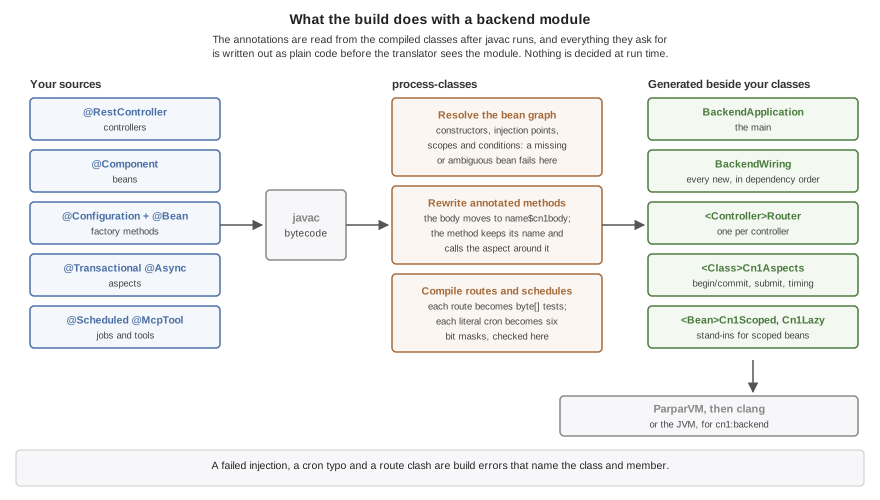
来自当前后端指南。生成的类是翻译器及其死代码分析的普通输入。
生成的 Router 将路由保存为字节,并根据声明的类型绑定参数。BackendWiring 按依赖顺序创建 Bean。缺少依赖项、候选不明确、构造器循环和重复路由会导致构建失败,并指出相关的类或注入点。
装配通过如下直接调用构造此控制器和下一节中的 Notes 服务:
运行时不会搜索 Notes 构造器或匹配的数据库 Bean。该调用就在生成程序中。依赖项更多时,构建会排列构造器调用的顺序,并随后生成字段或 setter 注入。私有 @Autowired 字段会获得生成的 setter,因此赋值仍然可以是直接调用。
这为你提供了一个有用的调试选项:跟随调用进入生成的代码,准确看到它构造了什么。它还允许原生链接器移除未引用的类。你用 Spring 的部分运行时灵活性,换取了一个能在部署前解析更多应用程序的构建。## 调用另一个方法时保持事务
如果你使用 Spring 通常的基于代理的事务,通过 this 进行的调用会绕过代理。即使注解仍然在方法上,这也可能让重构改变事务行为。Spring 在代理指南中记录了该限制及其字节码织入替代方案。
我们的构建会重写被注解的方法本身。因此,当同一对象上的另一个方法调用它时,@Transactional、@Async、@Timed 和 @Counted 会生效。它们也适用于私有方法以及你用 new 构造的项目类。
例如,这个服务在一个事务中写入一条 note 和一条 audit 记录。假设迁移已在配置的数据库中创建了 note(body) 和 audit(message):
注解会变成什么?构建将原始方法体移动到一个单独的方法中,并将其调用包装在事务处理中。这个伪代码展示了 Notes.add 的控制流;辅助方法名称和生成的类布局是实现细节:
无论你如何到达 add,方法体都在事务边界内运行。失败时,包装器将回滚规则应用于该边界并重新抛出错误。完成一个加入的事务可以将外部事务标记为回滚;它不一定会立即提交或回滚连接。此方法没有运行时注解查找或代理分派。处理器源代码和字节码织入器展示了这是如何实现的。
数据库连接是延迟借用的,在第一次数据库操作时进行。如果方法从未访问数据库,它可以返回而不触碰连接池。DataSource、生成的 DAO 和受管理的 ORM 会话加入与执行线程关联的事务。
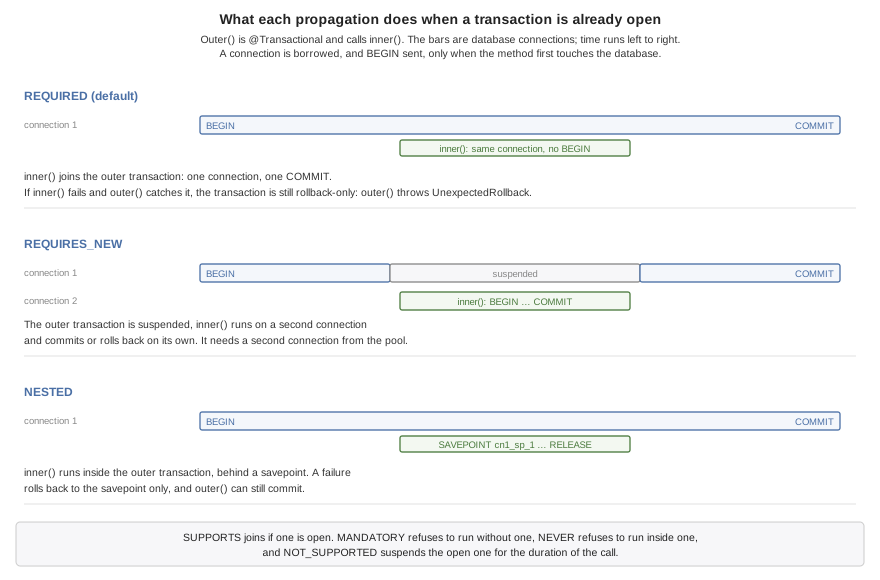
你可以选择所有七种传播模式:REQUIRED、REQUIRES_NEW、NESTED、SUPPORTS、MANDATORY、NOT_SUPPORTED 和 NEVER。重要的选择是:当事务存在时你希望发生什么,以及内部失败是否应该撤销外部工作。REQUIRES_NEW 需要另一个连接;NESTED 在当前连接上使用保存点。
支持只读声明、超时和显式回滚规则。不支持隔离级别选择。异步任务不会继承其调用者的事务,数据库事务无法撤销电子邮件或 HTTP 请求。数据章节详细说明了这些边界,包括当代码触及多个连接池时会发生什么。
无需为每个连接分配线程即可处理更多等待请求
如果你的处理器大部分时间都在等待另一台服务器,那么为每个连接分配一个操作系统线程代价高昂。你需要直接的阻塞代码,而不让每次等待占用一个宿主线程。
在 Linux 原生 HTTP 路径上,每个连接有一个 ParparVM 虚拟线程:一个在该连接生命周期内保留的栈。宿主线程运行这些栈。一个宿主拥有其连接及其 epoll 注册;虚拟线程留在该宿主上。当处理器需要尚未到达的字节时,运行时暂停其栈,并让宿主运行另一个连接。
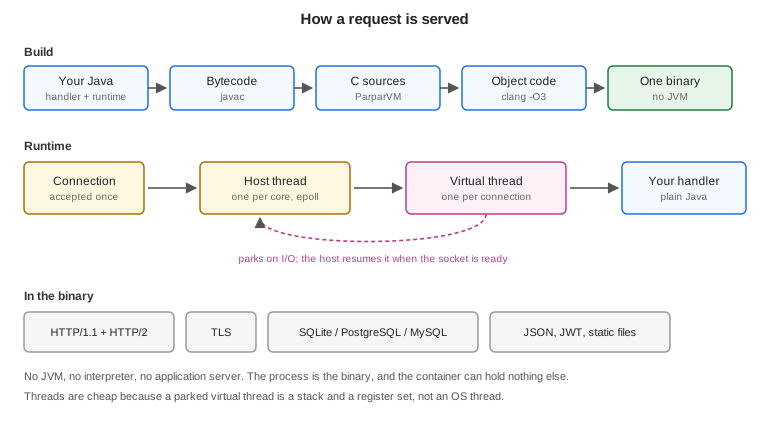
这适用于传入套接字之外。PostgreSQL 和 MySQL 查询使用相同的暂停机制。出站 HTTP,包括其 TLS 握手,也可以暂停。你的服务可以在普通的顺序 Java 中等待查询,而其他连接在同一宿主上继续。
后台任务现在也参与此模型。虚拟任务没有传入连接描述符,因此宿主使用唤醒管道来注意到新提交的工作。虚拟线程上的 Future.get() 在等待任务时协作式地让出。在那里阻塞宿主否则可能会停滞处理器需要其结果的那个任务。
这项工作还修复了一个微妙的调度器故障:每个让出点必须报告它是可运行的还是在等待 I/O。过时的原因可能导致处理器在 yieldNow() 之后卡住,或者在垃圾收集器背压后通过可运行路径发送 I/O 等待。虚拟线程 API 只有在这些转换在负载下保持正确时才有用。
你仍然需要为你的工作选择正确的执行器:
这些是 ParparVM 的虚拟线程,不是 JDK 实现。ThreadKind.PLATFORM 仍然是 @Async 和 @Scheduled 的默认值;VIRTUAL 在可用时请求原生设施,AUTO 在服务器有虚拟宿主时选择它。调度章节记录了回退行为和命名执行器。
调度工作而不会意外重复运行
调度方法在请求线程之外运行。当你希望以固定间隔启动时,使用固定速率;当你希望在上一次运行完成后暂停时,使用固定延迟。一旦作业耗时超过预期,这种区别就会变得明显:
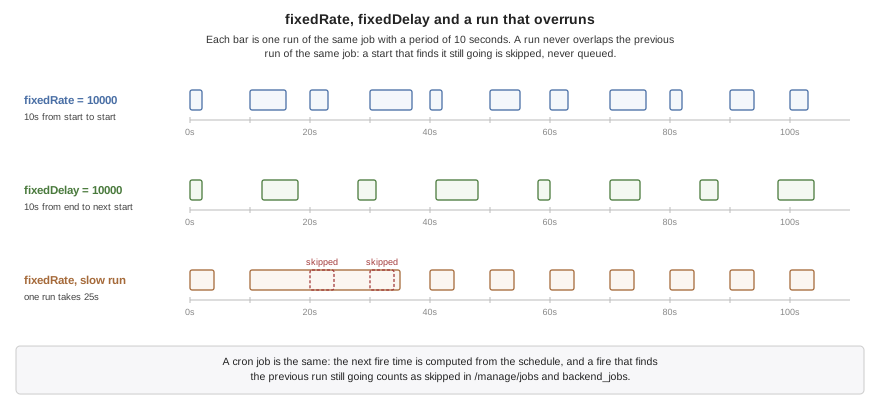
一个作业在进程内不会自身重叠。如果固定速率作业在其下一次启动时仍在运行,则跳过该启动。构建会验证方法签名和六字段 cron 表达式;配置可以提供实际的调度。
当你部署多个服务器实例时,每个实例都有一个调度器。数据库锁让它们跨副本协调一个作业。例如,@Scheduled(fixedDelay = 60000, lock = "purge") 请求一个共享锁。租约必须超过作业的最大运行时间,因为到期允许另一个实例认领它。你可以通过管理端点检查作业状态和跳过的运行。
随着服务增长,保持配置和状态显式
Spring 风格的表面超越了演示中的三个注解:
构建会捕获未解决的装配,但运行时配置仍然可能停用一个必需的 bean 或省略一个必要的值。请求、会话和惰性替身需要一个非 final 类和一个可访问的无参构造函数。该构造函数也会为替身运行。beans 章节解释了支持的组合及其限制。
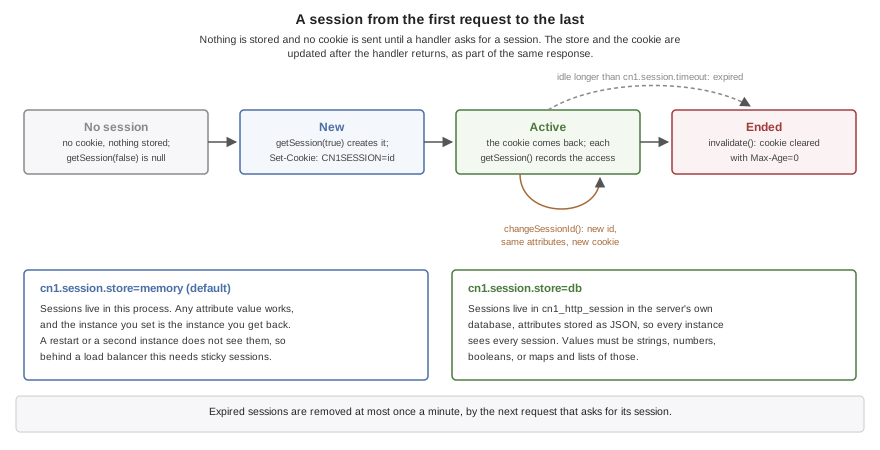
会话使用内存或数据库存储。它们是按需创建的,因此从不请求会话的 API 不会设置会话 cookie。在登录时使用 changeSessionId() 轮换标识符,当多个实例需要共享会话状态时使用数据库存储。会话 bean 在会话失效、发现过期或在服务器关闭时关闭时运行其 @PreDestroy 或配置的销毁方法。过期清理发生在请求遇到过期会话或触发定期清除时,而不是在确切的超时时刻。
没有通用的 ApplicationContext 查找,类路径上的任意 JAR 不会成为兼容的 Spring bean 库。原生后端源代码目前针对支持的运行时库使用 Java 8 语言级别。打包部署目标为 Linux。这些边界帮助你在尝试迁移之前决定小型服务是否适合此后端。
让你的服务在整个企业中可见
一个订单可以跨越客户端应用、你的原生后端和几个现有服务。后端可以继续传入的跟踪并在出站 HTTP 调用上传播它,以便你的运营团队可以在其现有的可观测性系统中跟踪该工作。可选的 OpenTelemetry 跟踪和指标被编译到可执行文件中,以及用于健康、作业和应用程序资源的管理端点。
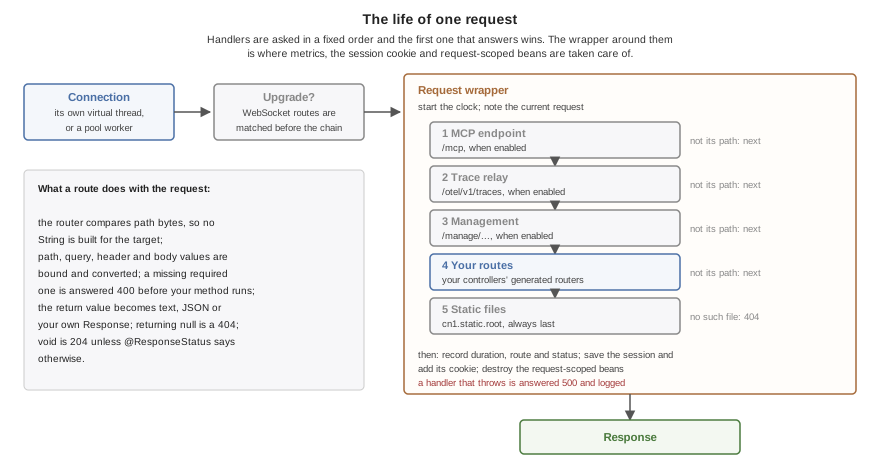
生成的服务器有一个定义的请求链。它自己的端点在应用程序路由之前运行,静态文件最后。一个包装器处理请求作用域、会话持久化和请求指标:
MCP 为你的开发工具提供了一种检查运行中服务的方式。代理可以通过开发工具列出路由和 bean、调用端点、检查最近的请求以及查询数据库状态。你可以使用 @McpTool 发布应用程序工具;构建会生成它们的参数模式和直接分派。
开发工具默认从打包服务器中排除。生产 MCP 端点需要令牌。周二的文章将客户端和后端连接到企业跟踪,然后涵盖指标和 MCP 开发工作流。
要尝试后端,请从后端指南和一个小端点开始,然后添加数据库操作并验证其回滚行为。PR #5908 背后的实现是本周扩展 API 的基础。
*** ** * ** ***## 本周更多内容
这就是后端故事。本次发布的其余内容涉及你应用的 UI、项目结构和提交流程。下面将更仔细地看看每篇即将发布的文章,以及一项小型地图改进。
你的 Java 服务器如何占用更少内存
上面的服务器对比显示,CN1 的峰值 RSS 为 57.8 MiB,而 Spring/GraalVM 为 117.0 MiB。周六的文章解释了这一更小占用背后的运行时工作:四字节对象头、更紧凑的字段、更少的临时对象以及垃圾回收方面的改动。我们还会看到该编译器自编译速度比 JDK 25 更快,并解释 ParparVM 的内存布局与 HotSpot 的紧凑对象头以及 Leyden 的 AOT 工作有何不同。对象头只是节省的一部分;整个服务器测量还包括代码、栈和库。
你的用户能看出自定义渲染的标签栏吗?
上周的 iOS 27 主题仍存在让我不满意的动效。这个对比展示了在点按、长按和拖动下的改进。观看原视频;时机和玻璃细节上的微小变化正是重点。 观看标签栏对比。
在这段并排模拟器录屏中,UIKit 位于 Codename One 上方。
周日的文章讲述了从帧测量到弹簧方程、vibrancy 和镜头渲染的逆向工程过程。你可以判断剩余的差异,并选择何时在你的应用中采用该主题。
选择 Gradle,从更少的文件开始
现在你可以创建一个更小的 Gradle 项目,并在需要时添加平台目录。独立后端不再需要附带一个客户端项目。这让项目树更易于浏览,并减少 LLM 上下文中的样板内容。我仍然更喜欢 Maven XML,原因与我当年在 Sun 使用的 make 文件有关,但你的偏好不应妨碍任何一种项目形态。
我们转换了仓库中的 HelloCodenameOne 示例:358 个文件变成了 305 个,九个 POM 变成了两个 Gradle Kotlin 文件。同一个应用减少了 53 个文件。该计数包括源代码和资源,不包括生成的构建输出,并来自实际转换器。
生成的 settings.gradle.kts 选择构建插件:
这是一个片段;生成的文件还配置了插件仓库。当包含 Gradle 支持的发布版本发布后,请使用它。周一的文章展示了完整设置和转换命令。
新的后端 Javadoc还将服务器 API 与客户端参考分开,并标识出二者之间共享的类。周一的文章介绍了这种拆分,以及单独的、实验性的 Gradle 9 Android 构建选项。为你的项目选择 Gradle,与更改 Android 构建器的 Gradle 版本,是相互独立的选择。
将你的应用纳入企业级追踪
你的移动端或 Web 应用可以成为一条追踪的起点,这条追踪会穿越原生 CN1 后端、现有 Java 服务和数据库。客户端和服务器传播相同的追踪上下文,因此将后端编译为原生代码不必在你的企业可观测性中留下缺口。你可以使用现有的 OTel collector 和追踪系统,并将 collector 凭据保存在服务器上。
周二的文章解释了相关设置、采样和指标标签,以便在流量增长时让遥测保持可控,还介绍了在开发期间检查服务的 MCP 工具。下游服务也必须参与追踪传播。
让你的浏览器应用拥有原生桌面应用的感觉
你的 Web 应用现在可以使用原生桌面操作系统样式:macOS(Aqua)、Windows(Fluent)或 Linux(Adwaita)。可选的 HTML 标题和菜单栏将命令置于应用上方。由于浏览器弹窗限制,JavaScript 移植版仍不支持额外的操作系统窗口;但这并不排除 Windows 浏览器。证书向导也采用了相同的桌面主题系列,延续了上周的设置工作。
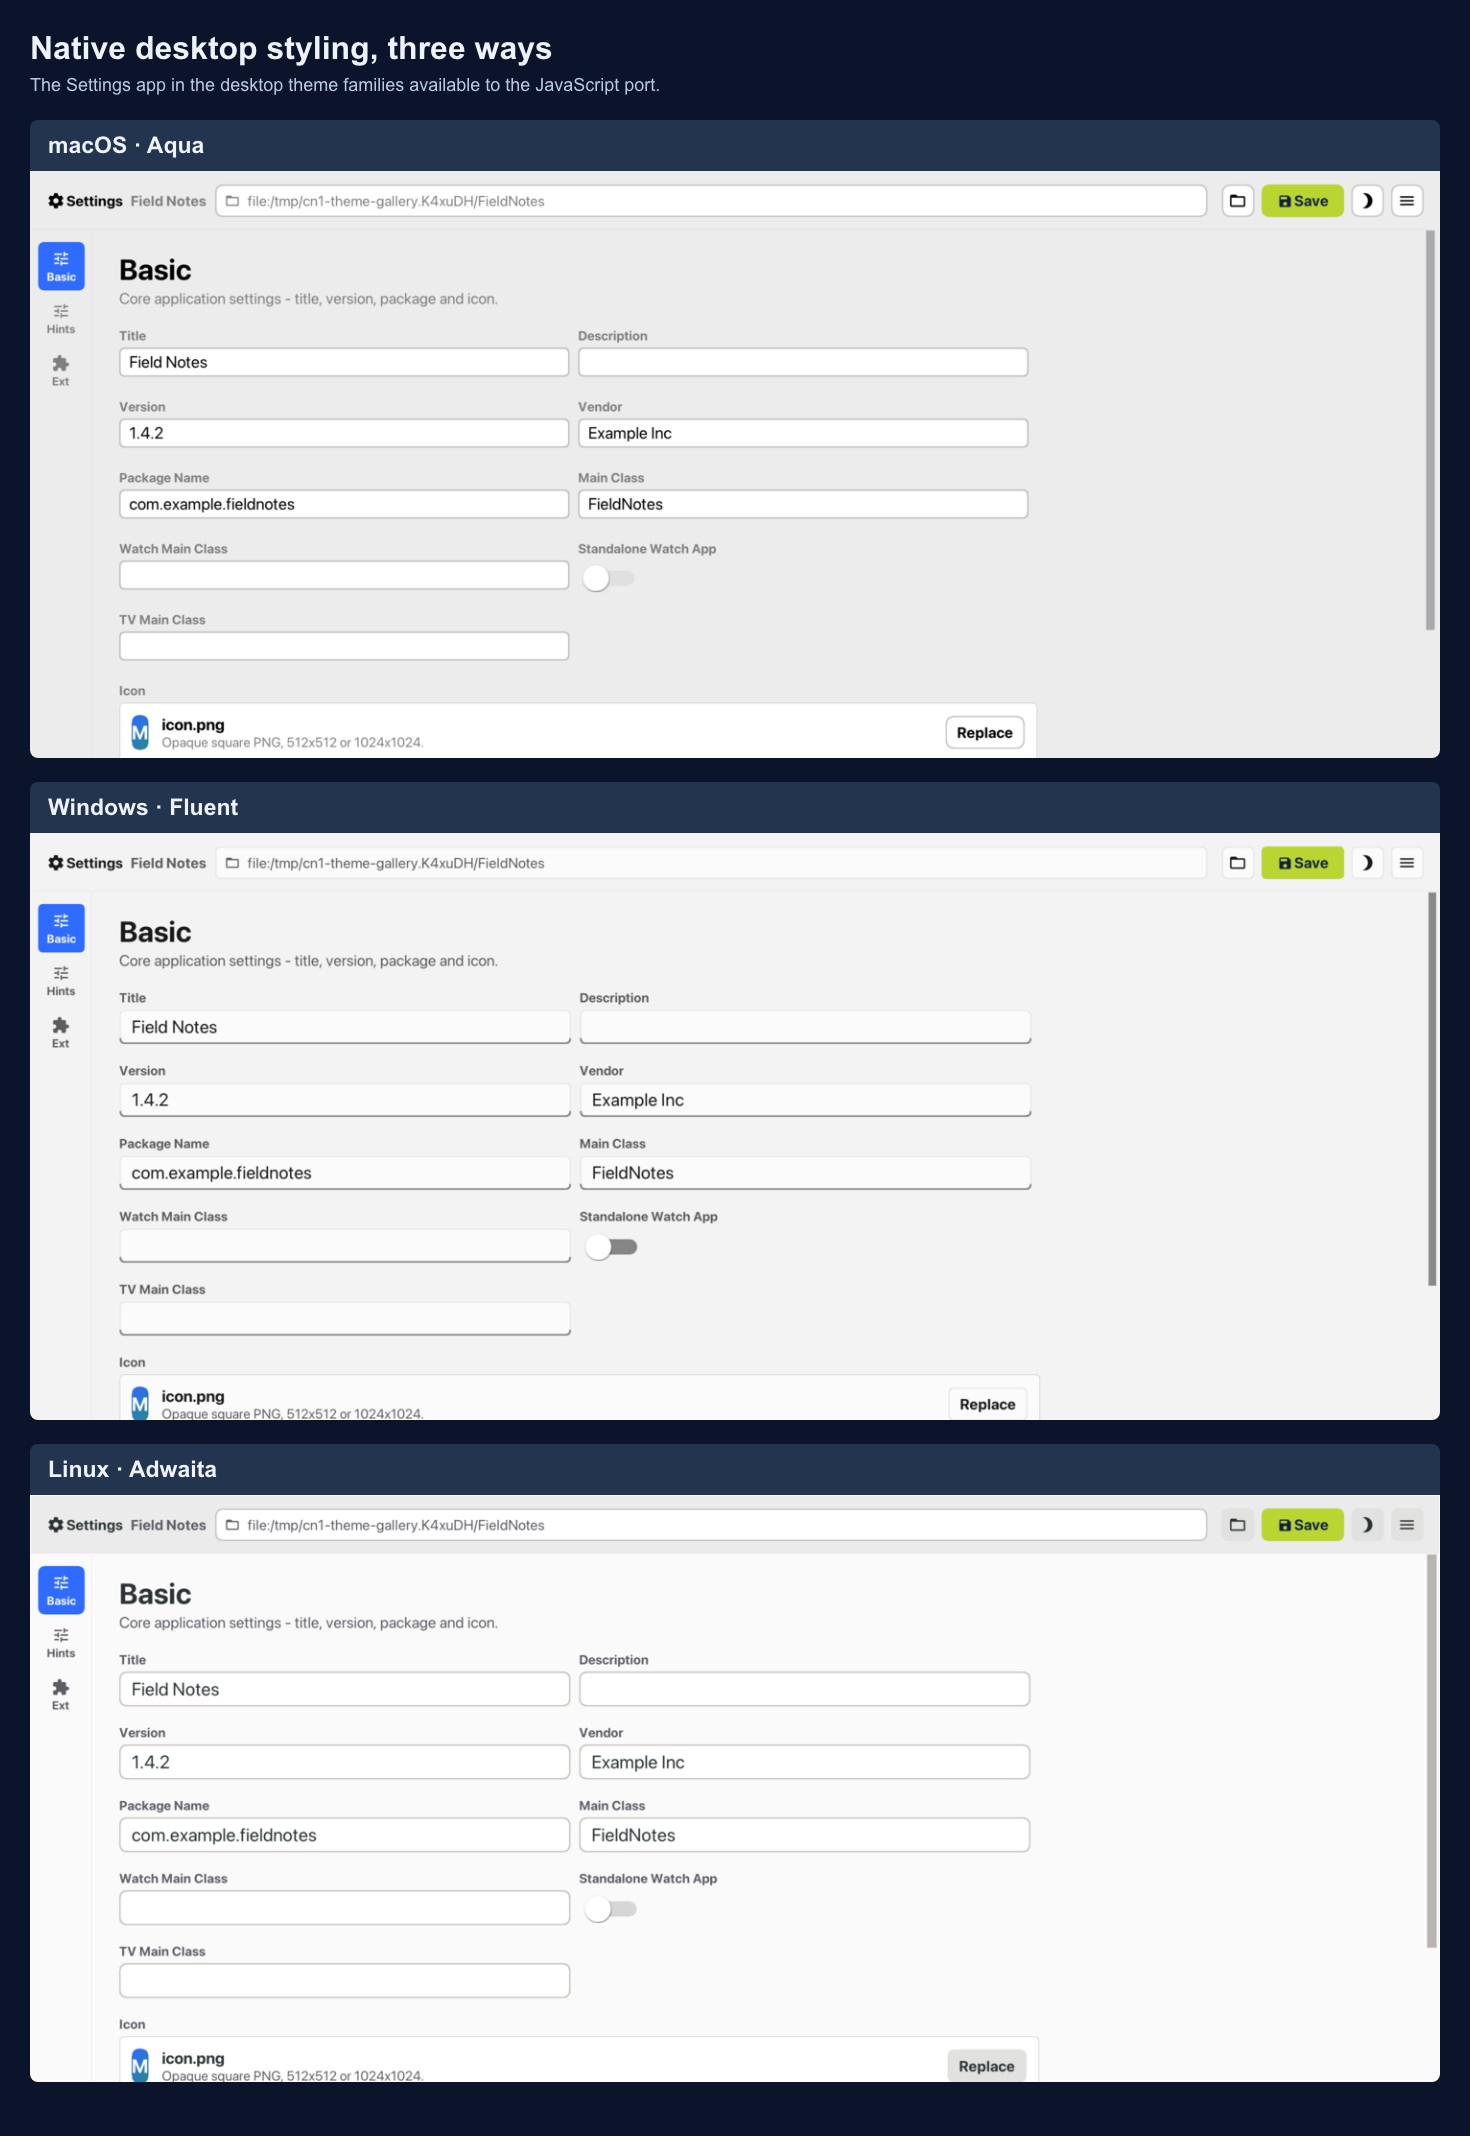
设置应用展示了 JavaScript 移植版中现已提供的三种桌面主题系列。
沿道路阅读街道名称
还有一项较小的地图改进:名称现在会跟随道路几何形状,在弯道处采用弯曲字形排布,在较直路段则使用直立文本。标签保持在路线叠加层之上,因此路线不会遮住你需要跟随的街道。
[LOADING...]
来自地图指南。渲染器会拒绝弯曲过急或与其他标签碰撞的排布。
这是 PR #5902 中持续进行的矢量地图工作的一部分。地图指南介绍了渲染器以及在不拉伸栅格瓦片的情况下进行更深度缩放。
你的发布还必须挺过提交环节
周四:周一别点鱼,周五别发版
一个在模拟器或设备上能正常运行的构建,仍可能导入 Apple 在提交时拒绝的 API。在这种情况下,不需要的导入只有在启用某些特定可选 API 时才会出现,因此大多数应用和我们通常的测试配置都漏掉了它们。新的检查会查找没有公开声明的已导入 SDK 符号,演练可选功能组合,并检查链接后的 Release 设备应用。它能捕获某一类会被另一个 happy-path 测试漏掉的错误。
这是围绕可选 Xcode 27 路径、推送和窗口的一段艰难回归周。有些问题相互重叠,以至于我们以为修复了一个 bug,却发现它的症状转移了。周四的文章解释了其中一次失败、为什么尽管明显会牺牲我们的周末我们仍在周五发布,以及更好的门禁如何保护你的发布不受我们的发布拖累。Apple 检查有明确的范围;它不能保证 App Store 审核通过。
本周有很多东西可以尝试。要让这些东西可靠地送到你手中,也还有工作要做。我希望你在下一个版本中花时间测试你应用中有用的东西,而不是帮我们理清回归问题。这就是为什么门禁工作与新功能同样重要。